n8n In The Loop 2026: Vom Workflow-Tool zum Betriebssystem für KI-Arbeit

n8n In The Loop 2026

KI-Agenten als Betriebssystem: n8n wird agent-first – und die Kontrolle bleibt beim Menschen

Auf der Konferenz In The Loop 2026 in Berlin stellte n8n seine neue Funktion Agents vor: Der Agent wird zur Eingangstür, die Workflows zu seinen Werkzeugen. 6,7 Mio. Workflows laufen bereits pro Monat, 60 % der Fortune 500 nutzen die Plattform. Was sich damit ändert und warum sich der Engpass im regulierten Umfeld vom Bauen aufs Prüfen verlagert, zeigt dieser Beitrag.

n8n will vom Workflow-Werkzeug zum Betriebssystem für KI-gestützte Arbeit werden. Das ist die Botschaft der Konferenz In The Loop 2026, die n8n am 14. Oktober 2026 in Berlin ausgerichtet hat.
Ich war für VARY.FY vor Ort, habe die Keynote von Gründer und CEO Jan Oberhauser gehört und mit dem n8n-Team, Ausstellern und Anwendern gesprochen. n8n ist deshalb besonders spannend, weil es sich vollständig selbst betreiben lässt. Genau dort entscheidet sich, ob KI im regulierten Umfeld kontrollierbar bleibt.

Vom Produkt zum Betriebssystem

Jan Oberhauser hat die neue Rolle von n8n in einem Satz zusammengefasst: KI-Modelle liefern die Intelligenz, n8n soll daraus verlässliche Arbeit im Unternehmen machen, die Menschen verstehen, steuern und gestalten können.

Die Zahlen aus der Keynote: 6,7 Mio. aktive Workflows laufen pro Monat, 300 % mehr als im Vorjahr. 60 % der Fortune 500 nutzen die Plattform, nach dem SAP-Investment im Mai 2026 wird n8n mit 5,2 Mrd. US-Dollar bewertet.

Bemerkenswert: n8n benennt klar, was sich nicht ändert. Die Community Edition bleibt kostenlos, selbst hostbar, mit einsehbarem Quellcode. Die Modellwahl bleibt beim Kunden – wichtig für Unternehmen, die sich nicht an einen US-Anbieter binden wollen.

Der Agent wird zur Eingangstür

Der größte Schritt: n8n Agents, seit Herbst 2026 in der Preview. Ein Agent wird einmal beschrieben – mit Modell, Anweisungen, Werkzeugen, Wissen – und lässt sich aus Chat, Slack, Telegram, per Zeitplan oder aus einem Workflow ansprechen.

n8n formuliert die Richtung in zwei Sätzen: Agent-first, workflow second – und AI-first, nicht AI-only. Der Agent wird zur Eingangstür, er versteht das Ziel und plant den Weg. Die Workflows werden zu seinen Werkzeugen und bleiben das Rückgrat, wo ein Ablauf jedes Mal gleich und nachvollziehbar laufen muss.
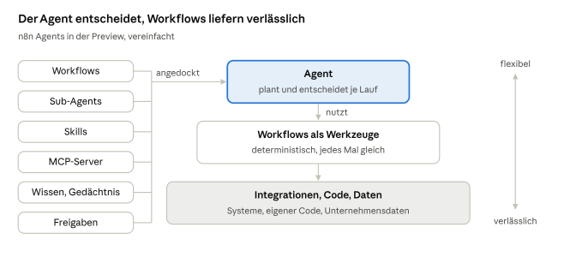
An einem Agenten hängen Workflows, Sub-Agents, Skills, MCP-Server, Wissen, ein Gedächtnis über Sitzungen hinweg und Freigaben. Eine vollständige Orchestrierung mehrerer Agenten fehlt noch. Aber die Architektur ist klar: ein KI-Betriebssystem auf einer offenen, selbst betreibbaren Plattform.

Agent im Workflow oder Workflow im Agenten?

In Make sitzt der Agent im Workflow, bei n8n Agents sitzt der Workflow im Agenten. Make hat seine KI-Agenten im Februar 2026 in den Szenario-Builder geholt; der Agent ist dort ein Baustein im Ablauf, gestartet über den Trigger des Szenarios. So hat auch n8n bisher mit dem AI-Agent-Node gearbeitet.

n8n Agents dreht das um: Der Agent ist ein eigenes Objekt mit eigenen Kanälen, Workflows, Sub-Agents, Skills und MCP-Server hängen als Werkzeuge an ihm, und bei jedem Lauf entscheidet der Agent, was er braucht. Beide Wege bleiben möglich, denn ein Workflow kann einen Agenten auch selbst aufrufen.
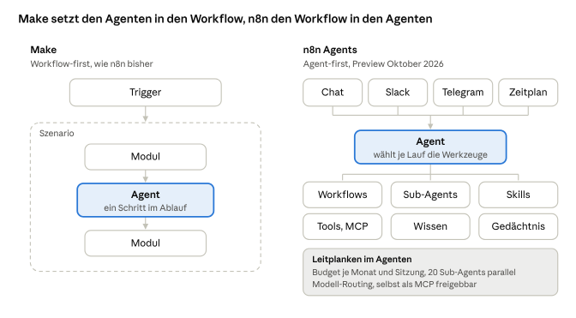
Mein Preview-Test zeigt eigene Leitplanken: Budget je Monat und Sitzung, bis zu 20 parallele Sub-Agents, Modell-Routing nach Schwierigkeitsgrad und die Freigabe des Agenten als MCP für andere Agenten. Damit wächst eine Steuerungsebene – genau das meint n8n mit Betriebssystem. Microsoft Teams fehlt noch als eigener Kanal, lässt sich aber über einen Teams-Trigger-Workflow anbinden. Stand: Oktober 2026.

Der LLM Council

Andrej Karpathy hat mit dem LLM Council gezeigt, wie mehrere Sprachmodelle eine Frage gemeinsam beantworten. Mit n8n Agents lässt sich das Muster in drei Stufen abbilden:

  • Mehrere Modelle verschiedener Anbieter beantworten dieselbe Frage parallel und unabhängig.
  • Die Antworten werden anonymisiert, jedes Modell bewertet die der anderen.
  • Ein Chairman fasst alles zusammen, die Freigabe gibt ein Mensch.
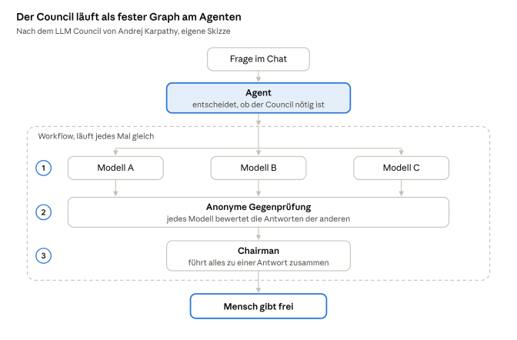
Entscheidend ist, wie man es baut. Der Agent ist die Eingangstür und entscheidet, ob eine Frage den Council braucht. Der Council selbst hängt als Workflow am Agenten und läuft jedes Mal in derselben Reihenfolge – ein echter Graph, nachvollziehbar und für unbeaufsichtigte Läufe geeignet.

Für regulierte Branchen ist das stark: Die Gegenprüfung ist eingebaut, nicht nachträglich organisiert. Die Kosten steigen mit jedem Modell – bei vier Modellen mindestens neun Aufrufe pro Frage. Budgets je Sitzung gehören daher von Anfang an dazu. Es ist eine eigene Konzeptskizze; das Original: Karpathys llm-council auf GitHub.

Verlässlichkeit wird zum Preis

Je größer die Konsequenz eines Prozesses, desto größer der Anspruch an Kontrolle und Verantwortung – der wichtigste Satz des Tages. Ein Agent baut eine Automation in 40 Sekunden, ein Mensch braucht 40 Minuten zum Prüfen. Der Engpass ist nicht mehr das Bauen, sondern das Prüfen. Inspektion, Tests und Evaluations gehören daher fest in den Ablauf, bevor etwas unbeaufsichtigt läuft.

n8n führt einen Reifeweg in drei Stufen ein:

  • Quick, in dem ein Mensch jeden Lauf begleitet;
  • Repeating, in dem der Agent wiederholt und unbeaufsichtigt läuft; und
  • Hardened, in dem aus dem bewährten Ablauf ein Workflow wird, der jedes Mal gleich läuft.

Dazu kommt eine Ausführungsumgebung, die nach jedem Schritt speichert, Fehler sicher wiederholt und Code in einer Sandbox ausführt.

Governance ordnet n8n auf vier Achsen: Zugriff, Guardrails, Ownership und Qualität sowie Sicherheit. Für jede Achse gibt es bereits Funktionen, weitere sind in Arbeit.

Was das fürs regulierte Umfeld heißt

Agenten machen Automatisierung schneller, aber nicht automatisch sicherer. Wer KI in Kanzleien, Versicherungen oder Verwaltungen einsetzt, muss jederzeit sagen können, welche Daten hineingehen, was daraus wird und wer dafür verantwortlich ist. Genau diese Fragen hat n8n in der Keynote ins Zentrum gestellt.

Daraus leiten wir drei Punkte ab:

  • 1. den Prozess stabilisieren, bevor automatisiert wird – ein unklarer Ablauf wird durch einen Agenten nicht besser, nur schneller unklar.
  • 2. Agenten für das Neue, Workflows für das Bewährte.
  • 3.Recht und Technik im selben Projekt: DSGVO, Geschäftsgeheimnisse und die Einordnung nach dem EU AI Act gehören in die Konstruktion des Workflows, nicht in eine Prüfung Monate später.

n8n bietet eine gute Grundlage: vollständiger Betrieb im eigenen Rechenzentrum, freie Modellwahl.

Fazit

In The Loop 2026 hat gezeigt, dass n8n die Agenten ernst nimmt, ohne die Kontrolle abzugeben. Für Unternehmen, die KI produktiv und nachvollziehbar betreiben wollen, ist das die richtige Richtung – wir haben uns deshalb als n8n-Partner beworben, mit Schwerpunkt auf dem regulierten Umfeld. Welche Ihrer Abläufe eignen sich für Agenten, welche besser für einen geprüften Workflow? Sprechen Sie uns an.

Autor

Sascha Scheffler ist diplomierter Maschinenbauingenieur und Experte für digitale Transformation.

Er ist zertifizierter Lean Administration Expert, hat einen Master in Business with AI (MBAI®) und ist AI Integration Expert.

Vereinbaren Sie jetzt Ihren Beratungstermin! https://varyfy.de/kontakt/
Meine Woche auf der No Code Week Frankfurt 2026

From Automation to Autonomy

Meine Woche auf der No Code Week Frankfurt 2026

Fünf Tage No Code Week in Frankfurt liegen hinter mir, und im Anschluss noch eine Keynote in Mainz. Ich war für VARY.FY vor Ort und habe mir vorgenommen, jeden Tag mitzuschreiben. Hier ist mein Rückblick, mit den Dingen, die wirklich hängen geblieben sind.

Tag 1: Erst einmal ankommen

Der erste Tag war bewusst entspannt. Nach der Ankunft gab es ein Meet and Greet am Main und eine kleine Stadttour, bei der man sich in Ruhe kennenlernen konnte. Beim Barbecue im Massif Central wurde es dann aber schnell fachlich. Wenn No-Coder und Automatisierer aufeinandertreffen, bleibt es eben nicht lange beim Smalltalk.

Wir waren insgesamt rund 130 Leute, die Sponsoren mitgezählt. Schön war das Wiedersehen mit ein paar bekannten Gesichtern aus unserer n8n Rhein-Main Community in Wiesbaden, etwa fünf Leute, die sich sonst bei AOE treffen. Genau dort sind die ersten guten Gespräche entstanden, locker und auf Augenhöhe.

Ich habe die Woche auch genutzt, um VARY.FY und unsere Haltung zu souveräner und verantwortungsvoller KI vorzustellen. Zum ersten Mal habe ich dabei unser Konzept gezeigt, wie wir Unternehmen künftig als Interim-AI-Manager begleiten wollen, damit sie europäische und lokale KI-Lösungen selbst und rechtssicher betreiben können. In den Gesprächen habe ich schnell gemerkt, wie groß der Bedarf danach ist.

Tag 2: Sovereign AI in der Praxis

Am zweiten Tag wurde es strategischer. Bart Veldhuizen von n8n sprach über den Aufbau echter Communities. Die Diskussion danach war so gut, dass am Ende sogar ein kostenfreies Ticket für das n8n Community Fest in Berlin am 16. Juli heraussprang, zu dem ich als Vertreter von VARY.FY eingeladen bin.

Florian Fürst hat anschließend gezeigt, wie man einen RAG-Agenten komplett auf quelloffener, deutscher Infrastruktur baut. Keine US-Cloud, keine Kompromisse. Das ist genau das Thema, an dem wir mit VARY.FY und unseren Partnern ohnehin arbeiten, und es ist schön zu sehen, wie erwachsen diese europäischen Lösungen inzwischen sind. Später hat Yulia Dmitrievna demonstriert, wie sich No-Code-Automatisierung mit KI zu einer selbstwachsenden Outreach-Datenbank verbinden lässt. Nebenbei habe ich meine erste App in Softr gebaut, einem deutschen Airtable-Mitbewerber, und war ehrlich überrascht, wie schnell ein kleines CRM stand.

Tag 3: Der Hackathon und FeierAbendKultur

Der Tag begann mit einer Live-Debatte über Data Ownership, also Souveränität und Autonomie. Danach haben wir in einem Silex Workshop in einer Stunde eine schnelle, barrierefreie Website gebaut, ohne Abo und ohne Lock-in.

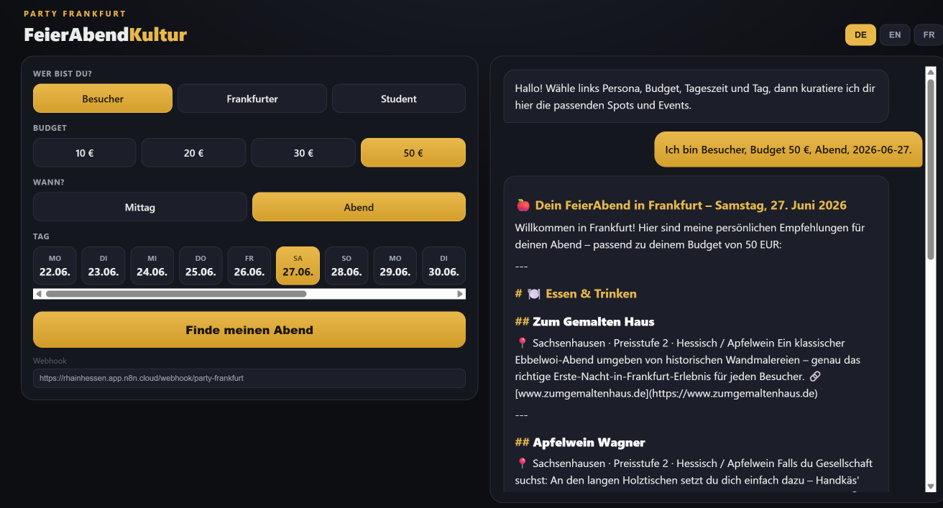
Am Nachmittag kam mein persönliches Highlight, der n8n Hackathon. Die Aufgabe: in drei Stunden, im Dreierteam, ein echtes Problem für ein Frankfurter Business lösen und alles live in n8n bauen. Unser Team, die „Rhinos“, hat dabei „FeierAbendKultur Frankfurt“ auf die Beine gestellt, einen Ausgeh- und Kulturconcierge.

Die Idee ist einfach: Man wählt seine Persona, also Besucher, Frankfurter oder Student, dazu Budget, Tageszeit und Wochentag. Dann bekommt man in Sekunden einen kuratierten Abend aus Essen und Events, mit echten lokalen Tipps, auf Deutsch, Englisch oder Französisch. Wichtig war uns, dass alles live läuft und kein Mockup ist. Im Hintergrund arbeiten ein WebScraper, der die Frankfurter Eventszene täglich selbst einliest, eine Airtable-Datenbank mit Dublettencheck, ein Plakat-Scanner über Mistral OCR und ein kleiner Chatbot, der daraus den passenden Plan formuliert.

FeierAbendKultur Frankfurt, der Ausgeh- und Kulturconcierge des Teams Rhinos  (nachgebaute Vorschau)

Gefühlt hatte die Hälfte der Teams Ideen rund um Frankfurt, Events und Ausgehen, entsprechend dicht war die Konkurrenz. Verdient gewonnen haben am Ende die Teams mit dem klarsten Nutzen und einer guten Portion Humor, etwa „Bears“ mit einem Meldesystem für kaputte Stellen in der Stadt und „Bulls“ mit ihrer „Frankfurt Pigeon Intelligence Agency“. Auf dem Papier lagen wir nicht vorne, aber das war an dem Tag fast egal. Was bleibt, ist der Beweis, wie schnell man mit No-Code und KI von der Idee zu etwas Lauffähigem kommt.

Tag 4: Keynotes und Systemdesign

Der Vormittag gehörte Sebastian Mertens von Make und der Keynote von Artur Mkrtchyan von Softr. Sein Punkt ist mir hängen geblieben: Kein Unternehmen will am Ende 8.000 Zeilen KI-generierten Spaghetti-Code besitzen oder Apps bauen, die unkontrolliert sensible Daten preisgeben. Was Unternehmen brauchen, ist visuelle Logik, klare Berechtigungen und Software, die sie selbst verstehen. KI ersetzt No-Code nicht, sie macht es schneller.

Danach wurde es technisch. Eine Session ist tief in das Zusammenspiel von n8n und Claude Code eingestiegen. Parallel lief ein Open Mic von Askan Schmeisser über Mattermost, den selbst hostbaren Open-Source-Zwilling zu Slack und Teams. Auf einem günstigen Hetzner-Server wird daraus eine gute Spielwiese für KI-Agenten wie Hermes oder OpenClaw, die sich als Bot in die Channels einklinken und in Threads mitlesen.

Mein eigenes n8n-Setup für die Orchestrierung ist über die Zeit ziemlich groß geworden, zu groß, um es in einer Stunde zu erklären. Deshalb habe ich mich am Abend hingesetzt und ein neues, schlankes Setup aufgebaut, das nur auf den nativen n8n-Skills und dem originalen n8n-MCP (Model Context Protocol) basiert. Das war meine Vorbereitung für den letzten Tag.

Tag 5: Open Mic und Abschluss

Der Finaltag startete mit einer schönen Überraschung, einem spontanen Ständchen für das Orga-Team. Auch wenn nur noch rund 40 Leute da waren, weil viele schon abgereist waren, war das ein richtig guter Moment.

Im Open Mic habe ich dann meinen umgebauten n8n Coworker vorgestellt, unter dem Titel „Automate your Automation“. Ich habe gezeigt, wie man mit dem Standard n8n-MCP und den n8n-Skills im Claude Setup arbeitet, als einfachen Einstieg ins Orchestrieren und Bauen von Workflows. Aus geplanten 45 Minuten wurden schnell zwei Stunden, und die Diskussionen danach waren das Wertvollste am ganzen Tag. Den Nachmittag haben wir genutzt, um das Gelernte zu sortieren, der Abend ist bei gutem Essen und kühlem Weißwein ausgeklungen. Der Termin für die nächste No Code Week steht übrigens schon: der 17. Mai 2027.

Abstecher: Keynote an der Hochschule Mainz

Direkt im Anschluss ging es für mich noch an die Hochschule Mainz, zur suMIT 2026, ausgerichtet vom IT Klub Mainz und Rheinhessen e.V. Dort durfte ich vor Studierenden meine Keynote „From Automation to Autonomy“ halten.

Ich habe zwei Use Cases aus der Praxis gegenübergestellt, einmal so, wie ich früher gearbeitet habe, und einmal so, wie moderne Systeme heute laufen. Mir ging es vor allem um einen Gedanken: Erst die Kombination aus einem deterministischen Rückgrat und probabilistischer KI macht ein System wirklich autonom. Die vielen Fragen der Studierenden im Anschluss waren ein schöner Abschluss, und ein gutes Zeichen, wie groß das Interesse an echter Praxis abseits der Theorie ist.

Der Tech Stack der Woche

Wer es konkret mag, hier die Werkzeuge, mit denen ich gearbeitet habe:

  • Workflow-Steuerung und Modelle: n8n, self hosted auf Hetzner für maximale Datenhoheit. Open-Source- oder Vollmodelle auf Ionos. Supabase als Open-Source-Lösung zum selbst Hosten. T.5 (Tensorfive) als Datenbank aus Mainz. Mistral als europäisches Modell.
  • Schnittstellen und Protokolle: MCP, n8n Standard Skills, Make Standard Skills.
  • Infrastruktur und Frontend: Airtable, Softr, WebApps mit Claude Code.

Unsere Kompetenzfelder

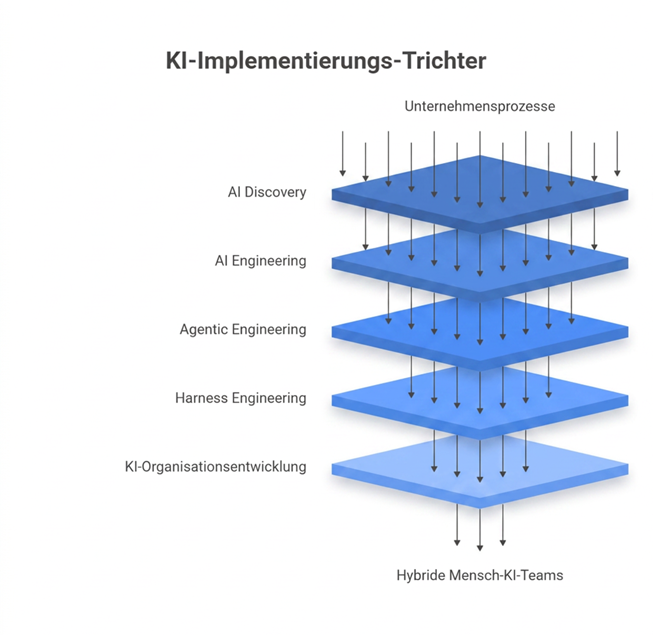
So ordnen wir bei VARY.FY unsere Arbeit ein, von der Organisation bis zur Pipeline:

  • KI-Organisationsentwicklung × Hybride Mensch-KI-Teams
  • Harness Engineering × Responsible AI
  • Agentic Engineering × AI Orchestration
  • AI Engineering × Data, Pipelines & RAG
  • AI Discovery × Process & Organisational Mining

VARY.FY Kompetenzfelder im Überblick

Diese fünf Felder greifen ineinander und ergeben einen durchgängigen Weg. Wir starten mit der Discovery und der Frage, wo sich KI im Unternehmen wirklich lohnt. In Plan und Design entwerfen wir darauf die passende Lösung. Danach folgt die Implementierung, also der Aufbau mit Daten, Pipelines und Orchestrierung. Im Enablement befähigen wir die Teams, sicher damit zu arbeiten. Und in der Organisationsentwicklung verankern wir KI dauerhaft in Strukturen, Rollen und Verantwortlichkeiten, sodass Mensch und KI verlässlich zusammenarbeiten.

Was ich mitnehme

Autonomie kommt nicht aus einem einzelnen Tool. Sie entsteht, wenn die Bausteine sauber zusammenspielen. Wer seine Workflows selbst hostet, behält die Kontrolle über die Daten. Wer auf offene Protokolle wie MCP setzt, bleibt unabhängig. Und wer KI orchestriert, statt nur einzelne Aufgaben zu automatisieren, kommt der Autonomie ein gutes Stück näher.

Das ist auch der Punkt, an dem wir mit VARY.FY ansetzen, an der Schnittstelle von Technologie, Recht und Ethik. Souveräne KI ist für mich die Voraussetzung dafür, dass Unternehmen KI rechtssicher und im Sinne des AI Act einsetzen können. Genau dabei unterstützen wir als Interim-AI-Manager.

Wenn Sie diesen Weg gehen wollen, ohne die Kontrolle abzugeben, sprechen Sie mich gerne an.

Autor

Sascha Scheffler ist diplomierter Maschinenbauingenieur und Experte für digitale Transformation. Er ist zertifizierter Lean Administration Expert, hat einen Master in Business with AI (MBAI®) und ist AI Integration Expert.

Vereinbaren Sie jetzt Ihren Beratungstermin! https://varyfy.de/kontakt/
Tokens verstehen: So nutzen Sie den VARY.FY Token-Rechner

Tokens verstehen

So nutzen Sie den VARY.FY Token-Rechner

Künstliche Intelligenz rechnet nicht mit Wörtern, sondern mit Tokens. Wie viele Tokens ein Text erzeugt, entscheidet darüber, wie schnell ein Modell arbeitet und was eine Anfrage kostet. Mit unserem Token-Rechner sehen Sie beides auf einen Blick.

Der VARY.FY Token-Rechner ist unter https://varyfy.de/tokenrechner/ aufrufbar und steht zur freien Verfügung.

In drei Schritten zeigen wir Ihnen, wie das Werkzeug funktioniert.

Schritt 1: Text eingeben

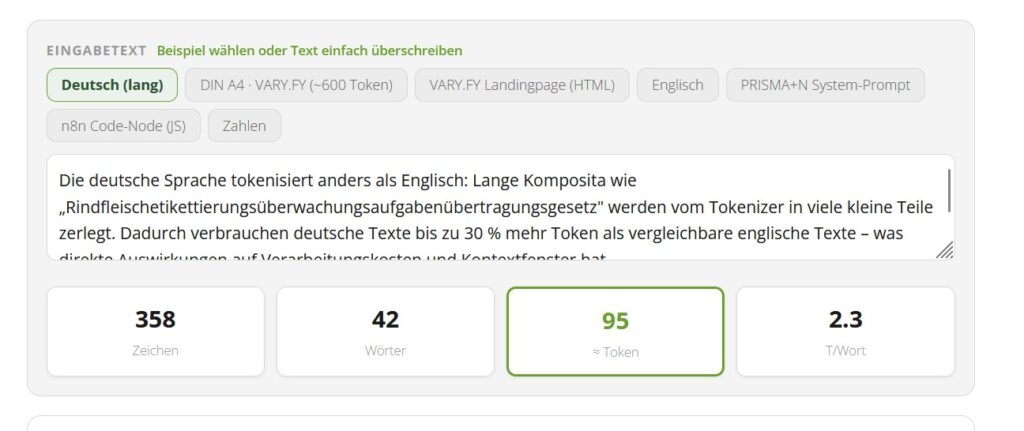
Oben finden Sie das Eingabefeld. Tippen Sie Ihren eigenen Text hinein oder überschreiben Sie den Beispieltext. Wenn Sie schnell starten möchten, wählen Sie einen der Beispiel-Buttons, etwa eine DIN A4 Seite oder einen System-Prompt. Über den Schalter oben rechts wechseln Sie zwischen Deutsch und Englisch.

Direkt unter dem Feld sehen Sie sofort die wichtigsten Kennzahlen: Zeichen, Wörter und die geschätzte Anzahl an Tokens.

Schritt 2: Die passende Sektion öffnen

Alle Bereiche lassen sich einzeln auf und zuklappen, damit Sie sich auf das konzentrieren, was Sie gerade brauchen.

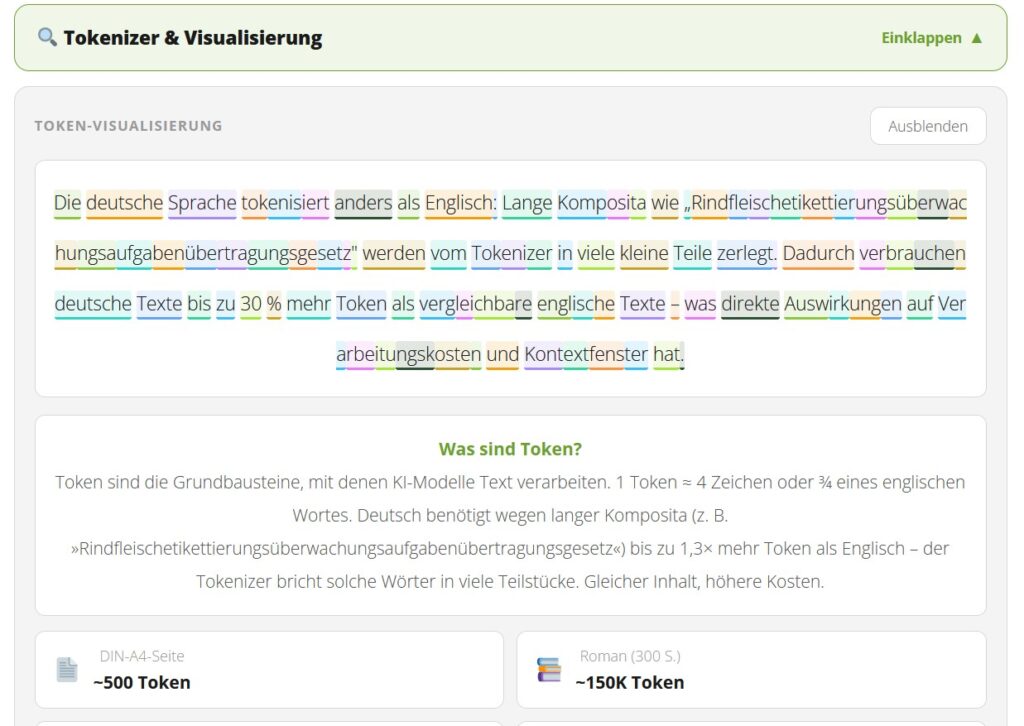
  • Tokenizer und Visualisierung: Hier wird Ihr Text farbig in einzelne Tokens zerlegt. So sehen Sie, dass lange deutsche Wörter in mehrere Teile zerfallen und dadurch mehr Tokens verbrauchen als kurze englische.
  • Vom Wort zur Zahl: Diese Sektion erklärt Schritt für Schritt, wie aus Text Mathematik wird, von der Tokenisierung über die Token-ID bis zum Zahlen-Vektor. Eine interaktive Tabelle übersetzt Ihren Text live in Zahlen.
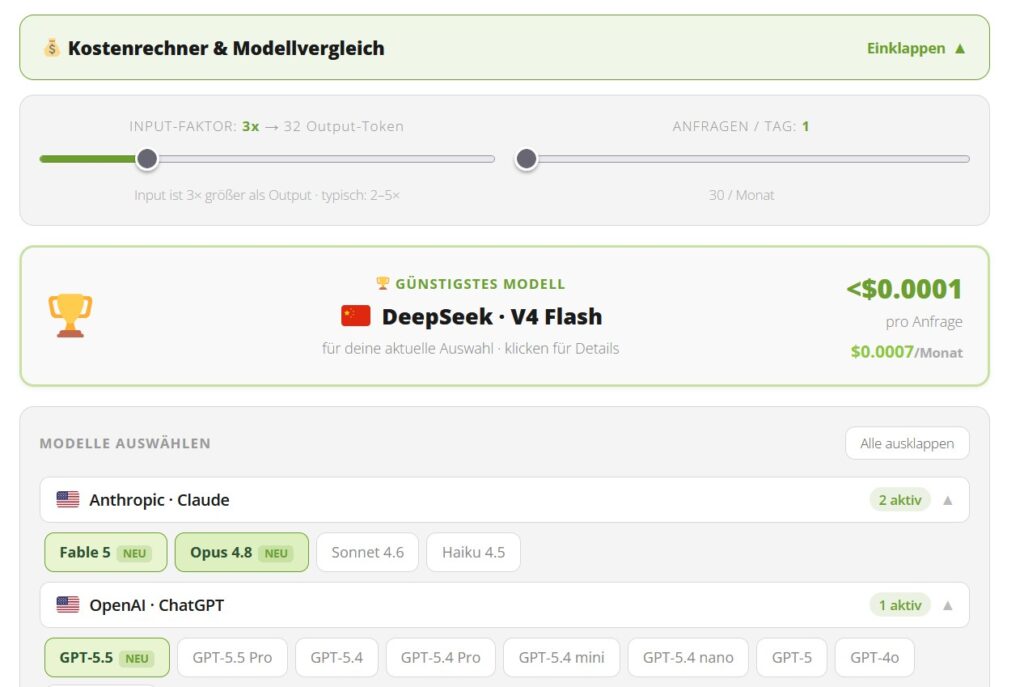
  • Kostenrechner und Modellvergleich: Wählen Sie ein oder mehrere Modelle aus und vergleichen Sie die Kosten. Sie stellen ein, wie viele Anfragen pro Tag anfallen und wie sich Eingabe und Ausgabe verteilen.
  • Kosten über die Zeit: Ein Diagramm zeigt, wie sich die Kosten über zwölf Monate summieren. Bewegen Sie den Regler von einer Anfrage pro Tag nach oben und beobachten Sie, wie die Kurve steigt.

Schritt 3: Modelle und Preise vergleichen

Im Kostenrechner sind die aktuellen Modelle hinterlegt, von Anthropic über OpenAI und Google bis zu Moonshot und Mistral. Eine kleine Flagge zeigt das Herkunftsland. Das günstigste Modell für Ihre Auswahl wird automatisch hervorgehoben, sodass Sie auf einen Blick die wirtschaftlichste Option erkennen.

Gut zu wissen

Die Token-Zahl ist eine fundierte Schätzung und kein offizieller Wert eines bestimmten Anbieters. Für die Budgetplanung ist sie sehr gut geeignet. Für die centgenaue Abrechnung sollten Sie die offiziellen Werte des jeweiligen Anbieters heranziehen.

Fazit

Mit dem Token-Rechner verstehen Sie in wenigen Minuten, wie ein Sprachmodell Ihren Text verarbeitet und was der Einsatz kostet. Ein Sprachmodell ist im Kern ein mathematisches Modell, und genau dieses Verständnis ist die Grundlage für einen sicheren und wirtschaftlichen Einsatz. Wenn Sie KI rechtssicher nutzen möchten, begleitet VARY.FY Sie an der Schnittstelle von Technologie, Recht und Ethik.

Autor

Sascha Scheffler ist diplomierter Maschinenbauingenieur und Experte für digitale Transformation. Er ist zertifizierter Lean Administration Expert, hat einen Master in Business with AI (MBAI®) und ist AI Integration Expert.

Vereinbaren Sie jetzt Ihren Beratungstermin! https://varyfy.de/kontakt/
Federated Learning

Neben der Zweckbindung ist im Rahmen der Verarbeitung personenbezogener Daten, deren Integrität und Vertraulichkeit zu gewährleisten. Die Datenverarbeitung muss daher unter anderem eine angemessene Sicherheit der personenbezogenen Daten gewährleisten, einschließlich Schutz vor unbefugter oder unrechtmäßiger Verarbeitung. Weiterhin ist der sogenannte Grundsatz der Datenminimierung zu beachten. Personenbezogene Daten müssen dem Zweck angemessen und erheblich sowie auf das für die Zwecke der Verarbeitung notwendige Maß beschränkt sein, d. h. es dürfen nur die Daten verarbeitet werden, zur Erreichung des zugrundliegenden Zwecks erforderlich sind.

Bei Interesse, Fragen und Austausch zu dem Thema oder wenn das für Ihr KI-Modell als Lösung interessant ist, kommen Sie gerne auf uns zu und melden sich hier.

  1. vgl. How much data from the public Internet is used for training LLMs? | by Michael Humor | GoPenAI ↩︎
  2. s. https://www.edps.europa.eu/system/files/2025-06/techdispatch_federated-learning_en.pdf ↩︎
  3. vgl. https://arxiv.org/abs/2103.07853 ↩︎