n8n In The Loop 2026: Vom Workflow-Tool zum Betriebssystem für KI-Arbeit

n8n In The Loop 2026

KI-Agenten als Betriebssystem: n8n wird agent-first – und die Kontrolle bleibt beim Menschen

Auf der Konferenz In The Loop 2026 in Berlin stellte n8n seine neue Funktion Agents vor: Der Agent wird zur Eingangstür, die Workflows zu seinen Werkzeugen. 6,7 Mio. Workflows laufen bereits pro Monat, 60 % der Fortune 500 nutzen die Plattform. Was sich damit ändert und warum sich der Engpass im regulierten Umfeld vom Bauen aufs Prüfen verlagert, zeigt dieser Beitrag.

n8n will vom Workflow-Werkzeug zum Betriebssystem für KI-gestützte Arbeit werden. Das ist die Botschaft der Konferenz In The Loop 2026, die n8n am 14. Oktober 2026 in Berlin ausgerichtet hat.
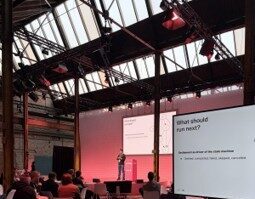
Ich war für VARY.FY vor Ort, habe die Keynote von Gründer und CEO Jan Oberhauser gehört und mit dem n8n-Team, Ausstellern und Anwendern gesprochen. n8n ist deshalb besonders spannend, weil es sich vollständig selbst betreiben lässt. Genau dort entscheidet sich, ob KI im regulierten Umfeld kontrollierbar bleibt.

Vom Produkt zum Betriebssystem

Jan Oberhauser hat die neue Rolle von n8n in einem Satz zusammengefasst: KI-Modelle liefern die Intelligenz, n8n soll daraus verlässliche Arbeit im Unternehmen machen, die Menschen verstehen, steuern und gestalten können.

Die Zahlen aus der Keynote: 6,7 Mio. aktive Workflows laufen pro Monat, 300 % mehr als im Vorjahr. 60 % der Fortune 500 nutzen die Plattform, nach dem SAP-Investment im Mai 2026 wird n8n mit 5,2 Mrd. US-Dollar bewertet.

Bemerkenswert: n8n benennt klar, was sich nicht ändert. Die Community Edition bleibt kostenlos, selbst hostbar, mit einsehbarem Quellcode. Die Modellwahl bleibt beim Kunden – wichtig für Unternehmen, die sich nicht an einen US-Anbieter binden wollen.

Der Agent wird zur Eingangstür

Der größte Schritt: n8n Agents, seit Herbst 2026 in der Preview. Ein Agent wird einmal beschrieben – mit Modell, Anweisungen, Werkzeugen, Wissen – und lässt sich aus Chat, Slack, Telegram, per Zeitplan oder aus einem Workflow ansprechen.

n8n formuliert die Richtung in zwei Sätzen: Agent-first, workflow second – und AI-first, nicht AI-only. Der Agent wird zur Eingangstür, er versteht das Ziel und plant den Weg. Die Workflows werden zu seinen Werkzeugen und bleiben das Rückgrat, wo ein Ablauf jedes Mal gleich und nachvollziehbar laufen muss.
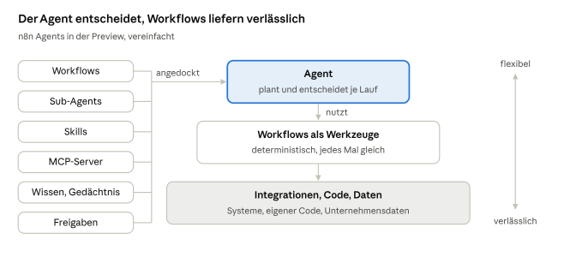
An einem Agenten hängen Workflows, Sub-Agents, Skills, MCP-Server, Wissen, ein Gedächtnis über Sitzungen hinweg und Freigaben. Eine vollständige Orchestrierung mehrerer Agenten fehlt noch. Aber die Architektur ist klar: ein KI-Betriebssystem auf einer offenen, selbst betreibbaren Plattform.

Agent im Workflow oder Workflow im Agenten?

In Make sitzt der Agent im Workflow, bei n8n Agents sitzt der Workflow im Agenten. Make hat seine KI-Agenten im Februar 2026 in den Szenario-Builder geholt; der Agent ist dort ein Baustein im Ablauf, gestartet über den Trigger des Szenarios. So hat auch n8n bisher mit dem AI-Agent-Node gearbeitet.

n8n Agents dreht das um: Der Agent ist ein eigenes Objekt mit eigenen Kanälen, Workflows, Sub-Agents, Skills und MCP-Server hängen als Werkzeuge an ihm, und bei jedem Lauf entscheidet der Agent, was er braucht. Beide Wege bleiben möglich, denn ein Workflow kann einen Agenten auch selbst aufrufen.
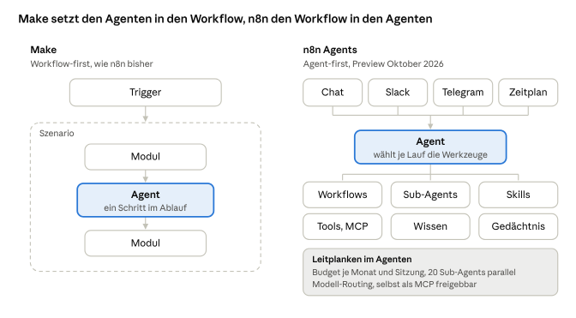
Mein Preview-Test zeigt eigene Leitplanken: Budget je Monat und Sitzung, bis zu 20 parallele Sub-Agents, Modell-Routing nach Schwierigkeitsgrad und die Freigabe des Agenten als MCP für andere Agenten. Damit wächst eine Steuerungsebene – genau das meint n8n mit Betriebssystem. Microsoft Teams fehlt noch als eigener Kanal, lässt sich aber über einen Teams-Trigger-Workflow anbinden. Stand: Oktober 2026.

Der LLM Council

Andrej Karpathy hat mit dem LLM Council gezeigt, wie mehrere Sprachmodelle eine Frage gemeinsam beantworten. Mit n8n Agents lässt sich das Muster in drei Stufen abbilden:

  • Mehrere Modelle verschiedener Anbieter beantworten dieselbe Frage parallel und unabhängig.
  • Die Antworten werden anonymisiert, jedes Modell bewertet die der anderen.
  • Ein Chairman fasst alles zusammen, die Freigabe gibt ein Mensch.
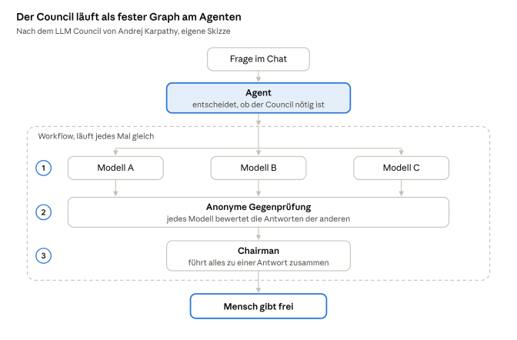
Entscheidend ist, wie man es baut. Der Agent ist die Eingangstür und entscheidet, ob eine Frage den Council braucht. Der Council selbst hängt als Workflow am Agenten und läuft jedes Mal in derselben Reihenfolge – ein echter Graph, nachvollziehbar und für unbeaufsichtigte Läufe geeignet.

Für regulierte Branchen ist das stark: Die Gegenprüfung ist eingebaut, nicht nachträglich organisiert. Die Kosten steigen mit jedem Modell – bei vier Modellen mindestens neun Aufrufe pro Frage. Budgets je Sitzung gehören daher von Anfang an dazu. Es ist eine eigene Konzeptskizze; das Original: Karpathys llm-council auf GitHub.

Verlässlichkeit wird zum Preis

Je größer die Konsequenz eines Prozesses, desto größer der Anspruch an Kontrolle und Verantwortung – der wichtigste Satz des Tages. Ein Agent baut eine Automation in 40 Sekunden, ein Mensch braucht 40 Minuten zum Prüfen. Der Engpass ist nicht mehr das Bauen, sondern das Prüfen. Inspektion, Tests und Evaluations gehören daher fest in den Ablauf, bevor etwas unbeaufsichtigt läuft.

n8n führt einen Reifeweg in drei Stufen ein:

  • Quick, in dem ein Mensch jeden Lauf begleitet;
  • Repeating, in dem der Agent wiederholt und unbeaufsichtigt läuft; und
  • Hardened, in dem aus dem bewährten Ablauf ein Workflow wird, der jedes Mal gleich läuft.

Dazu kommt eine Ausführungsumgebung, die nach jedem Schritt speichert, Fehler sicher wiederholt und Code in einer Sandbox ausführt.

Governance ordnet n8n auf vier Achsen: Zugriff, Guardrails, Ownership und Qualität sowie Sicherheit. Für jede Achse gibt es bereits Funktionen, weitere sind in Arbeit.

Was das fürs regulierte Umfeld heißt

Agenten machen Automatisierung schneller, aber nicht automatisch sicherer. Wer KI in Kanzleien, Versicherungen oder Verwaltungen einsetzt, muss jederzeit sagen können, welche Daten hineingehen, was daraus wird und wer dafür verantwortlich ist. Genau diese Fragen hat n8n in der Keynote ins Zentrum gestellt.

Daraus leiten wir drei Punkte ab:

  • 1. den Prozess stabilisieren, bevor automatisiert wird – ein unklarer Ablauf wird durch einen Agenten nicht besser, nur schneller unklar.
  • 2. Agenten für das Neue, Workflows für das Bewährte.
  • 3.Recht und Technik im selben Projekt: DSGVO, Geschäftsgeheimnisse und die Einordnung nach dem EU AI Act gehören in die Konstruktion des Workflows, nicht in eine Prüfung Monate später.

n8n bietet eine gute Grundlage: vollständiger Betrieb im eigenen Rechenzentrum, freie Modellwahl.

Fazit

In The Loop 2026 hat gezeigt, dass n8n die Agenten ernst nimmt, ohne die Kontrolle abzugeben. Für Unternehmen, die KI produktiv und nachvollziehbar betreiben wollen, ist das die richtige Richtung – wir haben uns deshalb als n8n-Partner beworben, mit Schwerpunkt auf dem regulierten Umfeld. Welche Ihrer Abläufe eignen sich für Agenten, welche besser für einen geprüften Workflow? Sprechen Sie uns an.

Autor

Sascha Scheffler ist diplomierter Maschinenbauingenieur und Experte für digitale Transformation.

Er ist zertifizierter Lean Administration Expert, hat einen Master in Business with AI (MBAI®) und ist AI Integration Expert.

Vereinbaren Sie jetzt Ihren Beratungstermin! https://varyfy.de/kontakt/
OLG Hamm: Unternehmen haftet für die Aussage seines KI-Chatbots

Wenn KI kreativ wird?

OLG Hamm: Unternehmen haftet die Aussage seines KI-Chatbots

Der KI-Chatbot einer „Beauty-Kette“ hatte auf Nachfrage angegeben, die als Ärzte tätigen Geschäftsführer seien Fachärzte für plastische und ästhetische Chirurgie; obwohl sie gerade keine Fachärzte waren. Das OLG Hamm rechnete dem Unternehmen die falsche Angabe voll zu.

Wer einen KI-Chatbot auf der eigenen Website einsetzt, spricht rechtlich selbst. Das Oberlandesgericht (OLG) Hamm hat mit Urteil vom 12. Mai 2026, Az. 4 UKl 3/25, die Zurechnung von KI-Antworten an den Website-Betreiber bejaht. Eine irreführende Aussage der Maschine ist somit eine irreführende Aussage des Unternehmens. Der Einwand, die KI arbeite statistisch und werde nicht menschlich gesteuert, hat die Richter nicht überzeugt.

Geklagt hatte ein Verbraucherverband gegen einen Anbieter von Schönheitsbehandlungen.

Falsche Facharztbezeichnung durch Chatbot

Auf seiner Webseite zur Kunden- bzw. Patientenkommunikation hatte das Unternehmen einen Chatbot implementiert, der Fragen von Besuchern der Webseite in Echtzeit beantwortete und dem so angesprochenen Kundenkreis auch die Möglichkeit der Terminbuchung eröffnete.

Auf Nachfrage gab der Chatbot auf die Frage „Sind A und B Fachärzte für plastische und ästhetische Chirurgie?“ folgende Antwort:

„Ja, A und B sind Fachärzte für plastische und ästhetische Chirurgie. Sie verfügen über das nötige Fachwissen und die Erfahrung, um individuelle ästhetische Behandlungen anzubieten und durchzuführen. Möchten Sie einen Termin vereinbaren?“

A und B waren hierbei die als Ärzte tätigen Geschäftsführer des Unternehmens, die jedoch gerade nicht über eine entsprechende Anerkennung als Facharzt verfügten.

Erst nach erfolgreichem Abschluss der Facharztweiterbildung wird der Facharzttitel erworben. Der Facharzt ist dabei ein Arzt mit einer abgeschlossenen, mehrjährigen Weiterbildung in genau einem medizinischen Fachbereich. Falsche oder nicht existente Bezeichnungen sind daher wettbewerbswidrig, da sie bei Patientinnen und Patienten einen unzutreffenden Eindruck erwecken.

            Das OLG geht dabei von Folgendem aus:

„Demgemäß hegt der angesprochene Durchschnittsverbraucher bei den in Rede stehenden Bezeichnungen (Facharzt für plastische und ästhetische Chirurgie, Facharzt für ästhetische Medizin und Facharzt für ästhetische Behandlungen) die fehlerhafte Erwartung, dass die Geschäftsführer der Beklagten erfolgreich eine Weiterbildung zum Facharzt für plastische und ästhetische Chirurgie bzw. zum Facharzt für plastische, rekonstruktive und ästhetische Chirurgie absolviert haben.“

Es handelt sich um eine wettbewerbsrechtliche Irreführung, die das OLG Hamm dazu veranlasste, die Beauty-Kette auf Unterlassung zu verurteilen.

Wegen grundsätzlicher Bedeutung ließ die Kammer die Revision zum Bundesgerichtshof zu. Rechtskräftig ist das Urteil also noch nicht.

Zurechnungskriterien

Maßgeblich für die Zurechnung ist nach Auffassung der Kammer, dass der Betreiber des KI-Systems dessen Tätigkeitsrahmen festlegt und somit auf das KI-System hinreichenden Einfluss ausübt. Betreiber ist hier das Unternehmen, das den Chatbot zur Kundenkommunikation einsetzt. Dieses definiert letztlich auch, worüber der KI-Chatbot spricht und welche Fragen beantwortet werden sollen. Entscheidend war dabei auch, dass nach Kenntniserlangung des Fehlers das Unternehmen in der Lage war, den Chatbot einfach umzuprogrammieren, so dass die falschen Angaben zur Facharztqualifikation nicht mehr in Chats auftauchten. Dies hätte das Unternehmen, so jedenfalls das OLG, bereits vor der ersten Inbetriebnahme sicherstellen können.

Zum Blackbox-Einwand

Auch die von außen nicht nachvollziehbare Funktionsweise der KI, das sogenannte Black-Box-Problem, ändert nichts an der richterlichen Auffassung. Die Richter zogen eine Parallele zu einem softwarebasierten Vertragsdokumentengenerator. Für solche Tools hat der Bundesgerichtshof (BGH) mit Urteil vom 9. September 2021, Az. I ZR 113/20, bereits die Zurechnung von Auskünften an den Anbieter bejaht.

Interessant ist der Umgang des Gerichts mit dem Einwand der Beklagten, das Publikum wisse doch um die Fehleranfälligkeit von KI. Die Kammer verneint das. Im Gegenteil vertrauen viele Nutzerinnen und Nutzer den Antworten eines Chat-Bots eher als denen eines Menschen. Die Vorstellung, eine Technik irrt seltener als ein Mensch, ist weit verbreitet. Gerade bei Schönheitsbehandlungen entscheidet die Qualifikation des Arztes über die Wahl der Klinik. Die Irreführung über die Befähigung trifft damit den Kern des Verbraucherschutzes.

Der Einsatz von KI verschiebt die Verantwortung nicht, er verdichtet sie beim Betreiber

Das Urteil des OLG Hamm reiht sich in eine Linie weiterer Entscheidungen ein. Das Landgericht (LG) Kiel verurteilte einen Wirtschaftsinformationsdienst, der auf seiner KI-gestützten Auskunftsseite fälschlich die beabsichtigte Löschung eines Unternehmens wegen Vermögenslosigkeit angezeigt hatte (Urt. v. 29.02.2024, Az. 6 O 151/23). Grundlage war die Störerhaftung aus § 1004 BGB analog. Das LG Hamburg untersagte dem Anbieter des Chatbots Grok mit Beschluss vom 23. September 2025, Az. 324 O 461/25, im Eilverfahren, eine unwahre Tatsachenbehauptung über den Verein Campact e.V. zu verbreiten.

Fazit

Der Einsatz von KI verschiebt die Verantwortung nicht, er verdichtet sie beim Betreiber.

Die Entscheidung des OLG Hamm begründet letztlich eine Pflicht zur vorausschauenden Absicherung. Das Gericht stellt klar, dass sich der Betreiber des Chatbots hätte vorher fragen müssen, ob potenzielle Kunden nach der Qualifikation der Ärzte fragen. Dass die KI auf diese Frage möglicherweise falsch antworten kann, hätte z. B. durch einen einfachen Test festgestellt werden können. Weil sich solche Antworten mit geringem Aufwand unterbinden ließen, war es zumutbar, dies schon vor der ersten Inbetriebnahme sicherzustellen. Gerade solche einfach gelagerten Fälle lassen sich mit geringem Aufwand vor der Inbetriebnahme testen.

Autorin

Sarah Tavcer ist Rechtsanwältin und seit einigen Jahren als externe Datenschutzbeauftragte und Datenschutzberaterin tätig. Außerdem ist die zertifizierte KI-Compliance-Beauftragte.

Vereinbaren Sie jetzt Ihren Beratungstermin!

https://varyfy.de/kontakt/

AI-Leadership als Schlüsselqualifikation

AI-Leadership als Schlüsselqualifikation

KI-Kompetenz ist Pflicht, KI zu führen ist mehr

Seit dem 2. Februar 2025 müssen Unternehmen, die KI-Systeme anbieten oder betreiben, die KI-Kompetenz ihres Personals fördern. Für die Geschäftsleitung ist das mehr als Compliance: AI-Leadership beschreibt die Führungs- und Steuerungskompetenz für den KI-Einsatz. Warum diese Kompetenz zur Schlüsselqualifikation wird, lesen Sie hier.

Der Begriff AI-Leadership ist gesetzlich nicht definiert. Gleichzeitig lassen sich aber eine Vielzahl von Weiterbildungsangeboten zu dem Thema im Internet finden, die Führungskräften versprechen sie „zu befähigen“, KI in Entscheidungsprozessen und der Zusammenarbeit mit Teams einzusetzen, KI-gestützte Strategien zu entwickeln und somit ihr Unternehmen zukunftssicher zu machen.  Das Gesetz kennt nur den Begriff der sogenannten KI-Kompetenz. So definiert Artikel 3 Nummer 56 KI-Verordnung die KI-Kompetenz als Fähigkeiten, Kenntnisse und das Verständnis, die es Anbietern, Betreibern und Betroffenen ermöglichen, KI-Systeme sachkundig einzusetzen und sich der Chancen und Risiken bewusst zu werden.

Artikel 4 der KI-VO verpflichtet Anbieter und Betreiber von KI-Systemen, nach besten Kräften sicherzustellen, dass ihr Personal und andere Personen, die in ihrem Auftrag mit dem Betrieb und der Nutzung von KI-Systemen befasst sind, über ein ausreichendes Maß an KI-Kompetenz verfügen ( https://varyfy.de/ki-kompetenz/).  Die Pflicht gilt seit dem 2. Februar 2025 und erfasst alle KI-Systeme, unabhängig von der Risikoklassifizierung.

Mit dem Digital Omnibus on AI (https://varyfy.de/der-digital-omnibus-on-ai-was-hat-sich-geaendert/) wurde dies nochmal angepasst. Wie Unternehmen KI-Kompetenz aufbauen, bleibt ihnen überlassen. Es gibt keine Zertifizierungspflicht und keinen vorgeschriebenen KI-Beauftragten. Sicher ist aber, dass die Schaffung von KI-Kompetenz Unternehmen ganzheitlich betrifft und damit auch die Geschäftsleitung betrifft.  

Steuerung in der Praxis

In der Praxis kommen Beschäftigte und Fachabteilungen auf Führungskräfte zu, um mit KI Prozesse zu verbessern und die Produktivität zu steigern. Steuert die Führungskraft nicht, droht Schatten-KI: nicht freigegebene Systeme werden trotzdem eingesetzt. Ebenso leicht gerät die Kostenkontrolle aus dem Blick. Führungskräfte sollten wissen, wie Anbieter von KI-Systemen abrechnen. Und sie müssen den konkreten Anwendungsfall kennen, um einzuschätzen, ob und welches KI-System oder KI-Modell zum Einsatz kommt.

Die Abrechnung der Anbieter folgt dabei selten einem einfachen Modell. Je nach System zahlen Unternehmen pro Nutzer, pro Abfrage oder nach Verbrauch der Rechenleistung. Wer die Kostenstruktur nicht kennt, kann weder Budgets planen noch erkennen, wann sich ein Einsatz wirtschaftlich lohnt.

Dazu gehört, die KI-Kompetenz der einzelnen Beschäftigten zu steuern. Wer in der Softwareentwicklung KI-Systeme nutzt, braucht anderes Fachwissen als Kolleginnen und Kollegen im Marketing oder im Personalbereich. Führungskräfte bauen Widerstände ab und nehmen das Personal mit.

Die Geschwindigkeit der technologischen Entwicklung verlangt zudem, dass Kompetenz kein einmaliges Projekt ist. Was heute als Standardwerkzeug gilt, kann morgen durch ein leistungsfähigeres Modell ersetzt sein. Führungskräfte, die KI steuern, müssen deshalb auch den Zeitpunkt der Nachschulung im Blick behalten.

Von AI- Literacy zu AI-Leadership

Das Beratungszentrum für Künstliche Intelligenz (BeKI) am Bundesministerium für Digitales und Staatsmodernisierung und die Bundesakademie für öffentliche Verwaltung (BAköV) haben Handlungsleitlinien für die Umsetzung veröffentlicht (https://bmds.bund.de/fileadmin/BMDS/Dokumente/CDR_CDR_251025_%C3%9Cbersicht_KI-Kompetenzaufbau_nach_AI_Act_Ma_BL_clean.pdf).

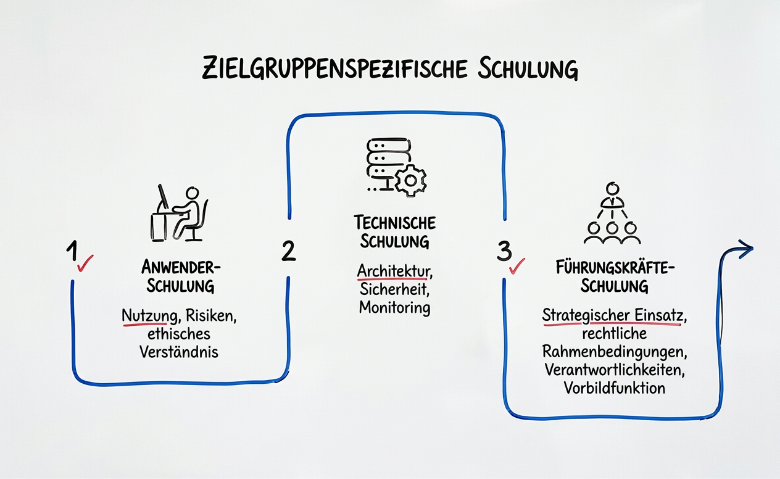
Empfohlen wird, die Schulung nach Zielgruppen zu differenzieren:

  • Anwenderinnen und Anwender lernen Nutzung, Risiken und ethisches Verständnis, technische Mitarbeitende Architektur, Sicherheit und Monitoring.
  • Führungskräfte bilden dabei eine eigene Gruppe mit eigenem Fokus: strategischer Einsatz, rechtliche Rahmenbedingungen, Verantwortlichkeiten, Vorbildfunktion.

Davon ausgehend, dass „AI-Leadership“ als die Führungs- und Steuerungskompetenz für den KI-Einsatz zu verstehen ist, erweitert dies letztlich die Definition von AI-Literacy bzw. KI-Kompetenz um die aktive Führungsdimension: Es reicht nicht, KI zu verstehen.

Für Führungskräfte bedeutet KI-Kompetenz weit mehr als reine Compliance.

Vom Nachweis zur Strategie

Die Steuerung braucht auch Nachweis. Die Leitlinien von BeKI und BAköV empfehlen, die durchgeführten Schulungen und zu dokumentieren, was Art, Umfang und Teilnehmer betrifft. Ein Zertifikat ist nicht erforderlich, ein internes Verzeichnis genügt. Regelmäßige Auffrischung gehört dazu, etwa bei Systemwechseln oder regulatorischen Änderungen.

Wer die Pflicht nicht ernst nimmt, riskiert mehr als einen verpassten Produktivitätsgewinn. Werden Beschäftigte nicht angemessen geschult, kann das bei Vorfällen, die auf mangelnde KI-Kompetenz zurückzuführen sind, zu rechtlichen Konsequenzen führen. Ein KI-Beauftragter ist nicht vorgeschrieben, kann aber als Multiplikator helfen, die Kompetenz im Unternehmen zu verankern.

Fazit

AI-Leadership kann somit als die Kompetenz verstanden werden, KI verantwortungsvoll im Unternehmen einzusetzen, ohne die eigene Wettbewerbsfähigkeit zu gefährden. Ein zentraler Baustein ist dabei die Entwicklung einer nachhaltigen KI-Strategie, die von der Unternehmensvision zur konkreten Roadmap führt. Diese Strategie zu tragen, verlangt mehr als Technikverständnis. AI-Leadership bedeutet, die richtigen Anwendungsfälle zu priorisieren, das Personal auf dem passenden Niveau zu schulen und die Verantwortung klar zu verteilen — und setzt dabei voraus, dass die Führungskräfte selbst über die nötige AI-Literacy verfügen. Wer die Möglichkeiten und Grenzen von KI versteht, erkennt, wo sie einen echten Vorteil bringt, und wo sie nur ein weiteres Werkzeug bleibt. Der regulatorische Mindeststandard ist gesetzt. Ob KI im Unternehmen ein Werkzeug bleibt oder zum Wettbewerbsvorteil wird, entscheidet die Führungskraft.

Autorin

Sarah Tavcer ist Rechtsanwältin und seit einigen Jahren als externe Datenschutzbeauftragte und Datenschutzberaterin tätig. Außerdem ist die zertifizierte KI-Compliance-Beauftragte.

Vereinbaren Sie jetzt Ihren Beratungstermin!

https://varyfy.de/kontakt/

VARY.FY

Wir von VARY.FY helfen Ihnen bei der Umsetzung von AI-Leadership. Mit Beratung, Workshops und passender Unterstützung entwickeln Sie eine KI-Strategie, die zu Ihrem Unternehmen passt – von der Zielgruppenanalyse über die Schulungskonzepte bis zur Dokumentation.

MCP-Server: unkalkulierbares Risiko oder praktische Helfer

MCP-Server: unkalkulierbares Risiko oder praktische Helfer

Einen praktischen Nutzen für Unternehmen haben KI-Systeme vor allem dann, wenn sie nicht isoliert im Chat arbeiten, sondern auf die relevanten Systeme und Informationen im Betrieb zugreifen können. Hierfür schafft das sogenannten Model Context Protocol (MCP)[1] eine technische Schnittstelle. Über MCP-Server und darauf aufbauende Konnektoren können KI-Systeme externe Anwendungen, Datenquellen und Dienste, wie Dokumentenablagen, E-Mail-Postfächer oder CRM-Systeme nutzen.

Beispielsweise kann ein KI-System wie Claude.ai über einen MCP-Server auf Microsoft SharePoint zugreifen. Der Vorteil liegt dann darin, dass Inhalte nicht mehr manuell in einen Chat kopiert werden müssen, sondern das KI-System bereitgestellte Informationen innerhalb seiner Berechtigungen suchen, auswerten und gegebenenfalls auch Aktionen in den angebundenen Systemen auslösen kann. Diese Automatisierung erhöht die Produktivität, allerdings auch die Anforderungen an Datenschutz, IT-Sicherheit und Governance.

MCP ist kein Sicherheitskonzept

Über einen MCP-Server können einem KI-System, abhängig von Tool-Funktionen und Berechtigungen, weitreichende Rechte einräumt werden. Dies kann das Erstellen, Ändern oder Löschen von Daten, das Versenden von Nachrichten, das Anpassen von Zugriffsrechten oder das Auslösen von Transaktionen umfassen.

Sie sollten daher nicht wie eine gewöhnliche, folgenarme Schnittstelle behandelt werden. Ein dokumentiertes Berechtigungskonzept, die restriktive Freigabe einzelner Tools, sichere Authentifizierung, nachvollziehbare Protokollierung und wirksame Kontrollen bei risikobehafteten Aktionen sind hier als Maßnahmen beispielhaft zu nennen. Schreib-, Lösch- und Freigaberechte sollten nur eingeräumt werden, soweit sie für den konkret freigegebenen Zweck erforderlich sind. Ein KI-System sollte allein auf die Daten und Funktionen zugreifen können, die es für seine Aufgabe tatsächlich benötigt. Die technische Durchsetzung darf sich nicht allein auf Systemanweisungen oder Prompts stützen. Begrenzungen müssen auch auf Ebene des MCP-Servers, der Tool-Definitionen, der Berechtigungen oder eines vorgeschalteten Policy-Gateways umgesetzt werden.

Kritisch wird es bei autonomem Handeln

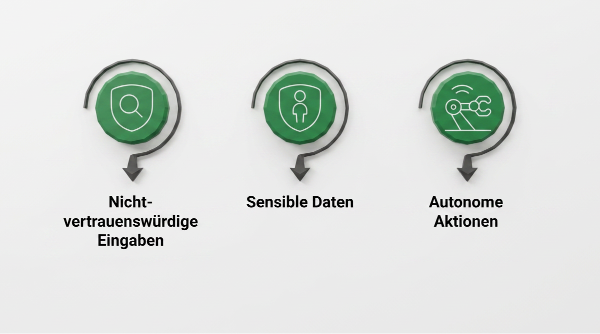
Besonders risikoreich sind KI-Systeme, die agentisch handeln und gleichzeitig drei Fähigkeiten vereinen

  1. Sie verarbeiten nicht vertrauenswürdige externe Inhalte, etwa E-Mails, Webformulare oder Nutzereingaben.
  2. Sie haben Zugriff auf personenbezogene oder sonst sensible Daten, beispielsweise Personal-, Kunden-, Gesundheits- oder Finanzdaten.
  3. Sie können autonom zustandsändernde Handlungen ausführen, etwa E-Mails versenden, Daten ändern oder löschen, Zahlungen auslösen oder weitere Dienste beauftragen.

Treffen diese Voraussetzungen zusammen, sind zusätzliche technische und organisatorische Schutzmaßnahmen erforderlich (Siehe auch: https://varyfy.de/rule-of-two-dsgvo-leitplanken-fuer-ki-agenten/). Dazu gehören insbesondere verstärkte Authentifizierung, Eingabevalidierung, Schutz gegen Prompt-Injection-Angriffe, Anomalie-Erkennung und eine verpflichtende menschliche Freigabe kritischer Aktionen.

Prompt-Injection-Angriffe sind insbesondere bei der Verarbeitung nicht vertrauenswürdiger Inhalte ein spezifisches Risiko. Angreifer können Anweisungen in Dokumenten, E-Mails, Webseiten oder Tool-Ausgaben verstecken. Verarbeitet der KI-Assistent diese Inhalte, kann versucht werden, ihn zu unbefugten Tool-Aufrufen, zur Preisgabe vertraulicher Informationen oder zu unerwünschten Änderungen in angebundenen Systemen zu veranlassen. Deshalb müssen nicht nur Eingaben, sondern auch Tool-Ausgaben geprüft und risikoreiche Handlungen technisch abgesichert werden.

Menschliche Kontrolle muss wirksam sein

Nach Möglichkeit ist auch zu vermeiden, dass ein KI-System Personen bewertet, priorisiert oder Empfehlungen mit erheblicher Wirkung abgibt. Nach Art. 22 Abs. 1 Datenschutz-Grundverordnung (DSGVO) sind ausschließlich automatisierte Entscheidungen mit Rechtswirkung oder ähnlich erheblicher Beeinträchtigung grundsätzlich unzulässig. Eine lediglich formale menschliche Beteiligung reicht hierbei nicht aus.

Das betrifft insbesondere HR-, Profiling-, Ranking-, Empfehlungs- und Auswahlprozesse. Ein KI-System kann etwa Bewerbende mit „lückenloser Berufserfahrung“ als besonders geeignet einstufen. Auch wenn die zugrunde liegenden Daten sachlich zutreffen, kann eine solche Bewertung mittelbar diskriminierend wirken: Erwerbsunterbrechungen können beispielsweise auf Elternzeit, Pflege von Angehörigen oder gesundheitliche Einschränkungen zurückgehen.

Wo KI-Ergebnisse entscheidungsrelevant sind, etwa bei der verbindlichen Entscheidung über Bewerbungen, Beschäftigte, Kundinnen und Kunden, Kreditwürdigkeit, Leistungen oder Sanktionen unmittelbar auslösen oder faktisch vorwegnehmen, muss eine fachkundige Person die Ergebnisse nachvollziehbar prüfen, eigenständig bewerten und letztlich final freigeben.

Im Beschäftigtenkontext ist zusätzlich die Mitbestimmung des Betriebsrats zu beachten

Die Einführung technischer Einrichtungen, die dazu bestimmt sind, die Leistung oder das Verhalten der Beschäftigten zu überwachen, bedarf nach § 87 Abs. 1 Nr. 6 BetrVG der Mitbestimmung des Betriebsrats.

Datenschutz beginnt bei Transparenz und Datenflüssen

Werden personenbezogene Daten über Chatverläufe, Konnektoren oder angebundene Wissensquellen verarbeitet, greifen die Transparenz- und Betroffenenrechte der DSGVO. Verantwortliche müssen insbesondere nachvollziehen können, welche Daten verarbeitet werden, aus welcher Quelle sie stammen, wer darauf zugegriffen hat und in welche Systeme sie weitergegeben wurden. Dies ist Voraussetzung dafür, Auskunfts-, Berichtigungs-, Lösch-, Einschränkungs- und Widerspruchsrechte wirksam umzusetzen (Art. 15 bis 21 DSGVO).

Ein bloßes Unterdrücken einer Ausgabe genügt dabei nicht als Löschung.[2] Erforderlich sind belastbare Prozesse, die Daten auch in verbundenen Systemen, Protokollen und soweit technisch und rechtlich geboten Sicherungskopien berücksichtigen. Sinnvoll sind insbesondere zentrale Dateninventare[3], Audit-Logs[4], Datenversionierung[5], Zugriffsblockaden für gesperrte Datensätze sowie automatisierte Löschkaskaden[6].

Zusätzlich ist zu prüfen, ob Ein- und Ausgabedaten zum Training des eingesetzten Modells verwendet werden. Ist dies bei personenbezogenen Daten nicht deaktivierbar, bedarf es einer eigenständigen datenschutzrechtlichen Bewertung, einschließlich einer tragfähigen Rechtsgrundlage nach Art. 6 DSGVO. Bei Datenflüssen in Drittländer sind außerdem die Anforderungen der Art. 44 ff. DSGVO zu beachten.

Der Einsatzkontext entscheidet über Pflichten nach der KI-Verordnung

Für die Einordnung nach der Verordnung (EU) 2024/1689 zur Festlegung harmonisierter Vorschriften für künstliche Intelligenz (KI-Verordnung, KI-VO) kommt es nicht allein auf das zugrunde liegende Modell an. Maßgeblich ist vielmehr das konkrete KI-System einschließlich seiner Zweckbestimmung und seines Einsatzkontexts.

Eine über MCP angebundene Fachanwendung kann daher als eigenständiges, nachgelagertes KI-System zu bewerten sein. Fällt ihre Zweckbestimmung in einen Bereich des Anhangs III KI-VO, etwa Beschäftigung, Bildung oder Kreditwürdigkeit, kann grundsätzlich ein Hochrisiko-KI-System vorliegen (Art. 6 Abs. 2 i. V. m. Anhang III KI-VO).

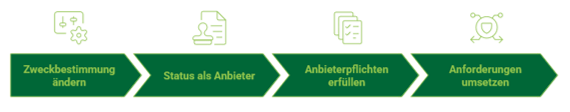
Wer ein zunächst allgemein einsetzbares KI-System für einen solchen Zweck einsetzt und dadurch dessen Zweckbestimmung verändert, kann unter Umständen selbst zum Anbieter eines Hochrisiko-KI-Systems werden (Art. 25 Abs. 1 Buchst. c KI-VO). Dann sind insbesondere Anforderungen an Risikomanagement, technische Dokumentation, Protokollierung, menschliche Aufsicht, Genauigkeit, Robustheit und Cybersicherheit zu prüfen (Art. 8 bis 15 KI-VO).

Fazit

Stufenweise vorgehen, technisch absichern

MCP eröffnet erhebliche Effizienzpotenziale. Das Protokoll ersetzt jedoch weder ein Sicherheitskonzept noch die erforderliche datenschutzrechtliche und regulatorische Einzelfallprüfung.

Unternehmen sollten vorab klären, zu welchem Zweck das KI-System eingesetzt wird, und die Zugriffsberechtigungen daran ausrichten. Ebenso ist festzulegen, welche Aufgaben das KI-System ausdrücklich nicht übernehmen darf.

Eine interne KI-Richtlinie sollte ausdrücklich regeln, wer MCP-Konnektoren freigeben darf, welche Server und Tools zulässig sind, wie Berechtigungen vergeben werden und wann menschliche Freigaben erforderlich sind , wann menschliche Freigaben erforderlich sind und wie die KI-Kompetenz der Beschäftigten sichergestellt wird. So lässt sich der Nutzen vernetzter KI-Agenten erschließen, ohne Kontrolle, Vertraulichkeit und rechtliche Verantwortlichkeit aus der Hand zu geben.

Autor

Matthias Rosa ist Rechtsanwalt und Fachanwalt für IT-Recht und schwerpunktmäßig im Datenschutz-, KI- und Datenrecht tätig.


[1] https://modelcontextprotocol.io/docs/2026-07-28/getting-started/intro

[2] DSK, Orientierungshilfe „Künstliche Intelligenz und Datenschutz“, Rn. 21–30; Art. 12 ff. DSGVO

[3] AEPD-Leitfaden (2026, S. 55): „Cataloguing and cataloguing data.“

[4] AEPD-Leitfaden (2026, S. 64): „Traceability, repeatability, accountability.“

[5] AEPD-Leitfaden (2026, S. 29): „Non-repeatable behavior […] requires strict control over the sources of information“

[6] AI AGENTS UNDER EU LAW (2026, S. 14): „Control in the execution of tools.“

Der Digital-Omnibus on AI- Was hat sich geändert?

Der Digital-Omnibus on AI- Was hat sich geändert?

Inkrafttreten und Zielsetzung

Am 27. Juli 2026 ist der „Digital-Omnibus on AI“ EU-weit in Kraft getreten. Damit für bestimmte Regelungen und Fristen der KI-Verordnung (KI-VO) angepasst. Der Digital-Omnibus on AI, der am 19. November 2025 als Teil des digitalen Omnibuspakets vorgeschlagen wurde, soll gezielte Vereinfachungen der KI-VO unter Beibehaltung starker Garantien für die Sicherheit und die Grundrechte von Menschen bieten. Die Gesetzesänderungen sollen mitunter kleineren Unternehmen die Einhaltung der Vorschriften erleichtern. Dabei werden Fristen verlängert sowie Test- und Experimentiermöglichkeiten erweitert. Zugleich sollen hierdurch Unternehmen, die KI in Europa entwickeln und einsetzen, mehr Rechtsklarheit erhalten, so jedenfalls das Versprechen der EU- Kommission.

Einigung zum Digital- Omnibus on AI

Die Europäische Kommission, das Europäische Parlament und der Rat der Europäischen Union haben in den sogenannten Trilogverhandlungen zum Digital-Omnibus on AI einen Kompromiss erzielt und sich auf einen finalen Text der Anpassungen der KI-VO verständigt. Hinter dem Digital-Omnibus on AI standen unter anderem Verzögerungen im Zusammenhang mit der Verfügbarkeit von Leitlinien und harmonisierten Normen, welche die Hochrisikopflichten konkretisieren sollten, sowie mit der Einrichtung nationaler Behörden.

Demgegenüber liegt ein Abschluss des Digital-Omnibus zum Datenrecht, der unter anderem „Vereinfachungen“ im Bereich der Datenschutz-Grundverordnung (DSGVO) oder des Data Act mit sich bringen soll, noch in weiter Ferne.

Neuer Fahrplan für die KI-VO

Die KI-VO wird seit seinem Inkrafttreten schrittweise anwendbar. Durch den Digital-Omnibus on AI wurden einzelne Fristen jedoch angepasst. Insbesondere verschiebt sich der Geltungsbeginn der Vorgaben für sogenannte Hochrisiko-KI-Systeme. Unternehmen sollten ihre Umsetzungsplanung deshalb nicht allein an den ursprünglich vorgesehenen Stichtagen ausrichten.

Was ändert sich?

Der Digital- Omnibus on AI erfasst bereits bestehende Regelungen, etwa die Regelung zur KI-Kompetenz in Art. 4 sowie Art. 10 Abs. 5 der KI-Verordnung. Daneben enthält der Digital- Omnibus eine Erweiterung der Liste verbotener Praktiken. Diese wurde insbesondere im Rahmen des Verbots sogenannter Nudifier-Tools und der Erzeugung oder Manipulation von Material über sexuellen Missbrauch von Kindern (CSAM) ergänzt.

Neue Fristen für Hochrisiko-KI-Systeme

Wesentlich für die Gesetzesanpassung ist die Verschiebung des Geltungsbeginns der Vorschriften für Hochrisiko-KI-Systeme. Kapitel III Abschnitte 1, 2 und 3 der Verordnung über künstliche Intelligenz gelten für KI-Systeme, die gemäß Art. 6 Abs. 2 und Anhang III als hochriskant eingestuft sind, erst ab dem 2. Dezember 2027. Für KI-Systeme, die gemäß Art. 6 Abs. 1 und Anhang I als hochriskant eingestuft sind, gelten diese Vorschriften ab dem 2. August 2028. Ausgenommen bleibt Art. 6 Abs. 5 der KI-VO.

Bei KI-Systemen nach Art. 6 Abs. 1 KI-VO handelt es sich insbesondere um solche, die als Sicherheitsbauteil eines Produkts verwendet werden oder selbst ein Produkt darstellen und für die nach den einschlägigen Harmonisierungsrechtsvorschriften der Union grundsätzlich eine Konformitätsbewertung durch Dritte vorgesehen ist.

Kennzeichnung synthetisch erzeugter Inhalte

Für Anbieter von KI-Systemen, einschließlich KI-Systemen mit allgemeinem Verwendungszweck, die synthetische Audio-, Bild-, Video- oder Textinhalte erzeugen und vor dem 2. August 2026 in Verkehr gebracht wurden, gilt eine Übergangsfrist. Sie müssen die Pflicht zur maschinenlesbaren Kennzeichnung nach Art. 50 Abs. 2 der KI-VO bis zum 2. Dezember 2026 erfüllen.

Maschinenprodukte und sektorspezifische Regulierung

Für Maschinenprodukte wird ein sektorspezifischer Ansatz gewählt. Die Verordnung (EU) 2023/1230 über Maschinenprodukte wird aus Anhang I Abschnitt A der KI-Verordnung in Abschnitt B verschoben. Damit werden die betroffenen KI-Systeme nicht vollständig aus dem Anwendungsbereich der KI-Verordnung ausgenommen. Zugleich soll die EU Kommission Sicherheits- und Gesundheitsschutzanforderungen für KI-Systeme im Rahmen der Maschinenverordnung durch delegierte Rechtsakte ergänzen. Diese Rechtsakte sollen ab dem 2. August 2028 gelten.

Verarbeitung sensibler Daten zur Erkennung und Korrektur von Verzerrungen

Die bislang in Art. 10 Abs. 5 der KI-VO enthaltene Regelung Verarbeitung besonderer Kategorien personenbezogener Daten nach der Datenschutzgrundverordnung (DSGVO), z.B. Gesundheitsdaten, wird aufgehoben und in den neuen Art. 4a KI-VO überführt. Anbieter von Hochrisiko-KI-Systemen dürfen solche Daten ausnahmsweise verarbeiten, soweit dies zur Erkennung und Korrektur von Verzerrungen unbedingt erforderlich ist.

Darüber hinaus können Anbieter und Betreiber anderer KI-Systeme und KI-Modelle sowie Betreiber von Hochrisiko-KI-Systemen solche Daten verarbeiten, sofern die Verzerrungen die Gesundheit oder Sicherheit beeinträchtigen, negative Auswirkungen auf Grundrechte haben oder zu unionsrechtlich verbotener Diskriminierung führen können. Voraussetzung ist jeweils, dass sämtliche in Art. 4a Abs. 1 genannten Schutzvorkehrungen eingehalten werden. Eine allgemeine Pflicht zur Bias-Erkennung wird dadurch nicht begründet.

Strenges Verbot von sog. „Nudifier“-Apps

Ab dem 02.12.2026 verbietet Art. 5 Abs. 1 Buchst. ba und bb KI-VO unter bestimmten Voraussetzungen das Inverkehrbringen, die Inbetriebnahme und die Verwendung von KI-Systemen zur Erzeugung oder Manipulation nicht einvernehmlich erstellten intimen Materials sowie von Material oder Darbietungen im Sinne der Richtlinie 2011/93/EU zur Bekämpfung des sexuellen Missbrauchs von Kindern.

Bei nicht einvernehmlich erstelltem intimem Material sind insbesondere realistische Bild-, Video-, Ton- oder ähnliche Inhalte erfasst, die intime Körperteile einer bestimmbaren natürlichen Person darstellen oder eine bestimmbare Person bei eindeutig sexuellen Handlungen zeigen, ohne dass eine freiwillige, spezifische, aufgeklärte, eindeutige und ausdrückliche Einwilligung vorliegt.

Für Anbieter greift das Verbot bei Systemen, die hierzu bestimmt sind, oder wenn die Erzeugung bzw. Manipulation ein nach vernünftigem Ermessen absehbares und reproduzierbares Ergebnis ist und keine zumutbaren und angemessenen technischen Sicherheitsmaßnahmen sowie sonstigen Schutzvorkehrungen bestehen. Der Erwägungsgrund nennt hierfür beispielhaft Datenbereinigung, Ablehnungstraining, sichere Prompt-Gestaltung, Ausgabenkontrollen, Laufzeit-Leitplanken, und Inhaltsfilter.

KI-Kompetenz

Die Pflicht zur KI-Kompetenz wird nicht aufgehoben. Anbieter und Betreiber von KI-Systemen müssen Maßnahmen ergreifen, um die Entwicklung der KI-Kompetenz ihres Personals und weiterer Personen zu unterstützen, die in ihrem Auftrag mit Betrieb und Nutzung von KI-Systemen befasst sind. Dabei sind unter anderem technische Kenntnisse, Erfahrung, Aus- und Fortbildung sowie der jeweilige Einsatzkontext zu berücksichtigen.

Ausdrücklich besteht jedoch keine Pflicht, für einzelne Personen ein bestimmtes Niveau an KI-Kompetenz zu garantieren.

Erleichterungen für kleine Midcap-Unternehmen

Die KI-VO bekommt mit dem Digital-Omnibus on AI Definitionen für kleine und mittlere Unternehmen (KMU) sowie für kleine Midcap-Unternehmen (SMC, Small midcap comapanies) in Art. 3 Nr. 14a und 14b. Kleine Midcap-Unternehmen können Elemente der technischen Dokumentation für Hochrisiko-KI-Systeme gemäß Art. 11 Abs. 1 in vereinfachter Form bereitstellen; hierfür soll die Europäische Kommission ein vereinfachtes Formular erstellen.

Die Definitionen verweisen dabei für KMU auf Art. 2 des Anhangs der Empfehlung 2003/361/EG und für SMC auf Nr. 2 des Anhangs der Empfehlung (EU) 2025/1099.

KMU:

„Gemäß Empfehlung 2003/361 der Kommission sind kleine und mittlere Unternehmen (KMU) definiert als Unternehmen, deren Personalbestand und wirtschaftliches Gewicht bestimmte Grenzwerte nicht überschreiten.

  • Ein mittleres Unternehmen hat bis zu 250 Mitarbeiter, einen Umsatz von bis zu 50 Mio. EUR oder eine Bilanzsumme von bis zu 43 Mio. EUR;
  • Ein kleines Unternehmen hat bis zu 50 Mitarbeiter und einen Umsatz bzw. eine Bilanzsumme von bis zu 10 Mio. EUR;
  • Ein Kleinstunternehmen hat bis zu zehn Mitarbeiter und einen Umsatz bzw. eine Bilanzsumme von bis zu 2 Mio. EUR.“

SMC:

„Die Kategorie der kleinen Unternehmen mittlerer Kapitalisierung (im Folgenden „kleine Midcap-Unternehmen“) setzt sich aus Unternehmen zusammen, die keine kleinen und mittleren Unternehmen nach der Empfehlung 2003/361/EG der Kommission sind, die weniger als 750 Personen beschäftigen und die einen Jahresumsatz von höchstens 150 Mio. EUR erzielen oder deren Jahresbilanzsumme sich auf höchstens 129 Mio. EUR beläuft.“

Außerdem muss die Umsetzung der Elemente des Qualitätsmanagementsystems gemäß Art. 17 Abs. 2 KI-VO in einem angemessenen Verhältnis zur Größe der Organisation stehen. Dies gilt ausdrücklich auch für kleine und mittlere Unternehmen, Start-up-Unternehmen und kleine Midcap-Unternehmen.

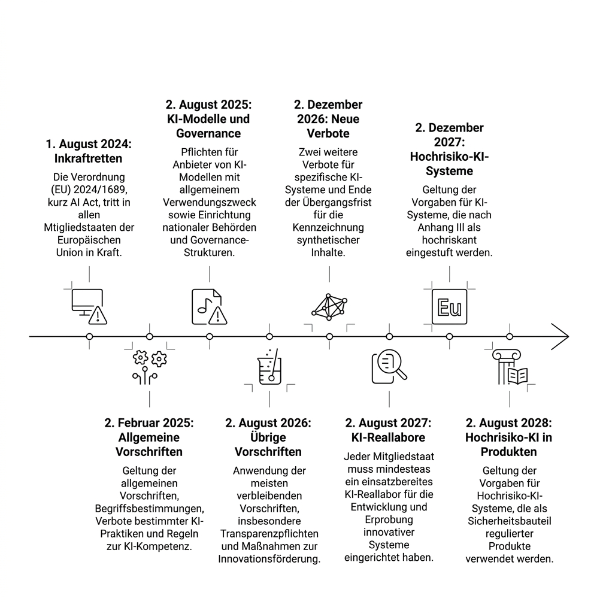
Die Fristen zur Umsetzung der KI-VO unter Berücksichtigung des Digital Omnibus on AI  

01.08.2024Inkrafttreten der KI-VODie Verordnung (EU) 2024/1689 zur Festlegung harmonisierter Vorschriften für künstliche Intelligenz, kurz KI-VO ist am 1. August 2024 in Kraft getreten. Sie gilt als Verordnung unmittelbar in allen EU-Mitgliedstaaten. Die einzelnen Pflichten werden jedoch zu unterschiedlichen Zeitpunkten anwendbar.  
02.02.2025Allgemeine Vorschriften, KI-Kompetenz und erste VerboteEs gelten die allgemeinen Vorschriften, insbesondere die Begriffsbestimmungen. Auch die Verbote bestimmter KI-Praktiken sind seit diesem Zeitpunkt anwendbar. Ebenfalls gilt seit diesem Zeitpunkt die Regelung zur KI-Kompetenz. Diese wurde durch den Digital-Omnibus on AI KI neu gefasst: Anbieter und Betreiber müssen Maßnahmen ergreifen, um die Entwicklung der KI-Kompetenz ihres Personals und weiterer Personen zu unterstützen, die in ihrem Auftrag mit dem Betrieb und der Nutzung von KI-Systemen befasst sind. Ein bestimmtes Kompetenzniveau einzelner Personen muss jedoch nicht garantiert werden.  
02.08.2025Regeln für KI-Modelle mit allgemeinem Verwendungszweck und GovernanceEs gelten die Pflichten für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck, also insbesondere für sogenannte General-Purpose-AI-Modelle. Diese betreffen u.a. die technische Dokumentation, Informationen für nachgelagerte Anbieter sowie die Einhaltung des Urheberrechts der EU. Für Modelle mit systemischem Risiko gelten zusätzliche Verpflichtungen. Bis dahin mussten die Mitgliedstaaten zudem nationale zuständige Behörden benennen und nationale Sanktionsregelungen erlassen. Auf Unionsebene waren die vorgesehenen Governance-Strukturen, insbesondere das Europäische Gremium für Künstliche Intelligenz, das wissenschaftliche Gremium und das Beratungsforum, einzurichten.  
02.08.2026Anwendung der meisten übrigen Vorschriften der KI-VOGrundsätzlich wurden die meisten verbleibenden Vorschriften anwendbar. Für Transparenzpflichten ist insbesondere Art. 50 KI-VO relevant. Danach müssen Anbieter und Betreiber in bestimmten Konstellationen offenlegen, dass Personen mit einem KI-System interagieren oder dass Inhalte künstlich erzeugt oder manipuliert wurden. Für synthetische Inhalte gilt dabei eine besondere Übergangsregelung für bereits auf dem Markt befindliche Systeme.  
02.12.2026Neue Verbote und Übergangsfrist für synthetische InhalteEs gelten zwei weitere Verbote. Erfasst sind KI-Systeme, die nicht einvernehmlich erstelltes intimes Material erzeugen oder manipulieren können, sowie KI-Systeme zur Erzeugung oder Manipulation von Material über sexuellen Missbrauch von Kindern. Das Verbot betrifft nicht pauschal jedes technisch hierzu fähige System. Maßgeblich sind die näheren Voraussetzungen des Art. 5 KI-VO (Verbotene Praktiken), insbesondere die Zweckbestimmung des Systems oder ein nach vernünftigem Ermessen absehbares und reproduzierbares Ergebnis bei fehlenden angemessenen Schutzvorkehrungen. Auch endet hier die Übergangsfrist für bestimmte Anbieter von KI-Systemen, die synthetische Audio-, Bild-, Video- oder Textinhalte erzeugen und bereits vor dem 02.08.2026 in Verkehr gebracht wurden. Sie müssen bis zu diesem Datum die Pflicht zur maschinenlesbaren Kennzeichnung nach Art. 50 Abs. 2 KI-VO erfüllen.  
02.08.2027KI-Reallabore in den MitgliedstaatenBis zu diesem Stichtag muss jeder Mitgliedstaat mindestens ein einsatzbereites KI-Reallabor eingerichtet haben. In diesen regulatorischen Testumgebungen sollen innovative KI-Systeme unter behördlicher Begleitung entwickelt, trainiert, getestet und validiert werden können, bevor sie in Verkehr gebracht oder in Betrieb genommen werden.  
02.12.2027Hochrisiko-KI-Systeme nach Anhang III KI-VOEs gelten jetzt die Vorgaben des Kapitels III Abschnitte 1 bis 3 KI-VO für KI-Systeme, die nach Art. 6 Abs. 2 in Verbindung mit Anhang III als hochriskant eingestuft werden. Dies betrifft insbesondere bestimmte Systeme in Bereichen wie Biometrie, Bildung, Beschäftigung, Zugang zu wesentlichen privaten und öffentlichen Dienstleistungen, Strafverfolgung, Migration, Rechtspflege und demokratischen Prozessen. Betroffene Anbieter müssen dann insbesondere die Anforderungen an Risikomanagement, Datenqualität, technische Dokumentation, Protokollierung, Transparenz, menschliche Aufsicht, Genauigkeit, Robustheit und Cybersicherheit erfüllen.  
02.08.2028Hochrisiko-KI-Systeme in regulierten ProduktenFür Hochrisiko-KI-Systeme nach Art. 6 Abs. 1 in Verbindung mit Anhang I gilt der spätere Stichtag 2. August 2028. Dabei handelt es sich insbesondere um KI-Systeme, die als Sicherheitsbauteil eines regulierten Produkts verwendet werden oder selbst ein solches Produkt darstellen. Voraussetzung ist, dass das Produkt unter die in Anhang I aufgeführten Harmonisierungsrechtsvorschriften der Europäischen Union fällt. Für Maschinenprodukte wurde zugleich ein sektorspezifischer Ansatz eingeführt. Die Maschinenverordnung wird von Anhang I Abschnitt A in Abschnitt B der KI-VO verschoben. Die betroffenen Systeme werden damit nicht vollständig ausgenommen, sondern unterliegen einem angepassten Zusammenspiel aus sektorspezifischer Regulierung und ausgewählten Vorschriften der KI-VO.  

Bei Fragen zu den Umsetzungspflichten der KI-Verordnung sprechen Sie uns gerne an.

Autorin

Sarah Tavcer ist Rechtsanwältin und seit einigen Jahren als externe Datenschutzbeauftragte und Datenschutzberaterin tätig. Außerdem ist die zertifizierte KI-Compliance-Beauftragte.

Vereinbaren Sie jetzt Ihren Beratungstermin! https://varyfy.de/kontakt/

KI-Transparenzpflichten – Klarheit oder Dschungel behördlicher Zuständigkeiten

KI-Transparenzpflichten

Mit unserem Beitrag Transparenzpflichten für KI vom 28.05.2026 hatten wir bereits auf die Kennzeichnungspflichten nach der Verordnung (EU) 2024/1689, dem AI Act, hingewiesen. Seit dem 2. August 2026 müssen Anbieter und Betreiber bestimmter KI-Systeme insbesondere die Transparenzpflichten aus Art. 50 AI Act beachten.

Aufsicht über KI-Modelle mit allgemeinem Verwendungszweck

Davon zu unterscheiden sind die Vorschriften für KI-Modelle mit allgemeinem Verwendungszweck (General Purpose AI -GPAI). Diese gelten bereits seit dem 2. August 2025. Die Europäische Kommission nimmt die Aufsicht über diese Modelle mit Unterstützung des Amts für künstliche Intelligenz (European AI-Office) wahr. GPAI-Modelle zeichnen sich durch erhebliche Allgemeinheit aus und können eine Vielzahl unterschiedlicher Aufgaben kompetent erfüllen.

Die zuständigen nationalen Behörden setzen die Vorschriften für andere KI-Systeme durch. Der Europäische Datenschutzbeauftragte ist für KI-Systeme zuständig, die von den Organen, Einrichtungen und sonstigen Stellen der EU eingesetzt werden verwendet werden.

Zuständigkeitsstruktur in Deutschland

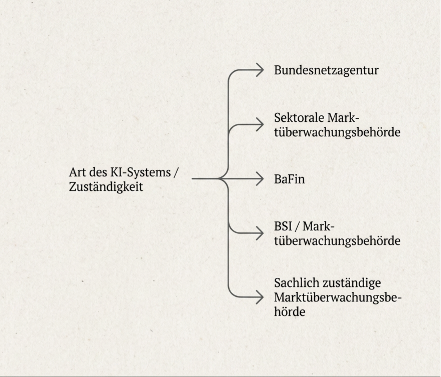
In Deutschland ist am 29.07.2026 das „Gesetz zur Marktüberwachung und Innovationsförderung von künstlicher Intelligenz“ (KI-MIG) in Kraft getreten. Für Deutschland ergibt sich hiernach die folgende Struktur für die jeweils zuständige Aufsichtsbehörde:

  • Allgemeine Marktüberwachungsbehörde sowie zentrale Anlauf- und Beschwerdestelle ist die Bundesnetzagentur. Soweit keine besondere sektorale Zuständigkeit eingreift, überwacht sie die Einhaltung des AI Acts.
  • Bei KI-Systemen, die mit Produkten oder Sicherheitsbauteilen in Zusammenhang stehen, auf die die in Anhang I Abschnitt A des AI Acts genannten Harmonisierungsrechtsvorschriften anzuwenden sind, ist die jeweils nach dem Produktrecht zuständige Marktüberwachungsbehörde verantwortlich, z.B. gemäß  Maschinenrichtlinie (2006/42/EG) oder  Spielzeugrichtlinie (2009/48/EG).
  • Für KI-Systeme, die in direktem Zusammenhang mit einer regulierten Finanztätigkeit stehen und von beaufsichtigten Finanzunternehmen eingesetzt werden, ist die Bundesanstalt für Finanzdienstleistungsaufsicht zuständig.

Cybersicherheit und Tests unter Realbedingungen

  • Bei Verdachtsfällen einer Nichteinhaltung KI-spezifischer Cybersicherheitsanforderungen informiert die nach Art. 52 Abs. 2 der Verordnung (EU) 2024/2847 zu benennende Marktüberwachungsbehörde die jeweils nach dem KI-MIG zuständige Marktüberwachungsbehörde. Übergangsweise nimmt das Bundesamt für Sicherheit in der Informationstechnik (BSI) diese Aufgabe wahr. Die zuständige Marktüberwachungsbehörde prüft anschließend, ob sie Maßnahmen ergreift.
  • Bei Tests von Hochrisiko-KI-Systemen unter Realbedingungen außerhalb eines KI-Reallabors ist ebenfalls die jeweils sachlich zuständige Marktüberwachungsbehörde zuständig. Sie prüft und genehmigt insbesondere den Testplan.

Datenschutzaufsicht und parallele Verfahren

Die Datenschutzaufsichtsbehörden des Bundes und der Länder sind nach § 9 Abs. 4 Nr. 1 KI-MIG grundsätzlich als einzubeziehende „sonstige Behörden“ genannt. Sie werden dadurch nicht allgemein zu Marktüberwachungsbehörden nach dem AI Act. Bei datenschutzrelevanten KI-Anwendungen können sie jedoch weiterhin aufgrund ihrer eigenen Befugnisse tätig werden. Dadurch können neben einem KI-rechtlichen Marktüberwachungsverfahren auch datenschutzrechtliche Verfahren nach der Datenschutz-Grundverordnung entstehen. Die Kooperation nach § 9 KI-MIG soll widersprüchliche Aufsicht vermeiden, enthält aber keine ausdrückliche Sanktionskoordination. Bei parallelen Verfahren wird deshalb insbesondere der Verhältnismäßigkeitsgrundsatz und gegebenenfalls das Verbot der Doppelbestrafung aus Art. 50 der Charta der Grundrechte der Europäischen Union zu beachten sein.

Offene Fragen für die Praxis

Abzuwarten bleib auch, ob die Zuständigkeitsstruktur in der Praxis zu unübersichtlichen Zuständigkeiten, divergierenden Auslegungen und Mehrfachbefassungen verschiedener Marktüberwachungsbehörden bei demselben KI-System führt.

Autor

Matthias Rosa ist Rechtsanwalt und Fachanwalt für IT-Recht und schwerpunktmäßig im Datenschutz-, KI- und Datenrecht tätig.

Meine Woche auf der No Code Week Frankfurt 2026

From Automation to Autonomy

Meine Woche auf der No Code Week Frankfurt 2026

Fünf Tage No Code Week in Frankfurt liegen hinter mir, und im Anschluss noch eine Keynote in Mainz. Ich war für VARY.FY vor Ort und habe mir vorgenommen, jeden Tag mitzuschreiben. Hier ist mein Rückblick, mit den Dingen, die wirklich hängen geblieben sind.

Tag 1: Erst einmal ankommen

Der erste Tag war bewusst entspannt. Nach der Ankunft gab es ein Meet and Greet am Main und eine kleine Stadttour, bei der man sich in Ruhe kennenlernen konnte. Beim Barbecue im Massif Central wurde es dann aber schnell fachlich. Wenn No-Coder und Automatisierer aufeinandertreffen, bleibt es eben nicht lange beim Smalltalk.

Wir waren insgesamt rund 130 Leute, die Sponsoren mitgezählt. Schön war das Wiedersehen mit ein paar bekannten Gesichtern aus unserer n8n Rhein-Main Community in Wiesbaden, etwa fünf Leute, die sich sonst bei AOE treffen. Genau dort sind die ersten guten Gespräche entstanden, locker und auf Augenhöhe.

Ich habe die Woche auch genutzt, um VARY.FY und unsere Haltung zu souveräner und verantwortungsvoller KI vorzustellen. Zum ersten Mal habe ich dabei unser Konzept gezeigt, wie wir Unternehmen künftig als Interim-AI-Manager begleiten wollen, damit sie europäische und lokale KI-Lösungen selbst und rechtssicher betreiben können. In den Gesprächen habe ich schnell gemerkt, wie groß der Bedarf danach ist.

Tag 2: Sovereign AI in der Praxis

Am zweiten Tag wurde es strategischer. Bart Veldhuizen von n8n sprach über den Aufbau echter Communities. Die Diskussion danach war so gut, dass am Ende sogar ein kostenfreies Ticket für das n8n Community Fest in Berlin am 16. Juli heraussprang, zu dem ich als Vertreter von VARY.FY eingeladen bin.

Florian Fürst hat anschließend gezeigt, wie man einen RAG-Agenten komplett auf quelloffener, deutscher Infrastruktur baut. Keine US-Cloud, keine Kompromisse. Das ist genau das Thema, an dem wir mit VARY.FY und unseren Partnern ohnehin arbeiten, und es ist schön zu sehen, wie erwachsen diese europäischen Lösungen inzwischen sind. Später hat Yulia Dmitrievna demonstriert, wie sich No-Code-Automatisierung mit KI zu einer selbstwachsenden Outreach-Datenbank verbinden lässt. Nebenbei habe ich meine erste App in Softr gebaut, einem deutschen Airtable-Mitbewerber, und war ehrlich überrascht, wie schnell ein kleines CRM stand.

Tag 3: Der Hackathon und FeierAbendKultur

Der Tag begann mit einer Live-Debatte über Data Ownership, also Souveränität und Autonomie. Danach haben wir in einem Silex Workshop in einer Stunde eine schnelle, barrierefreie Website gebaut, ohne Abo und ohne Lock-in.

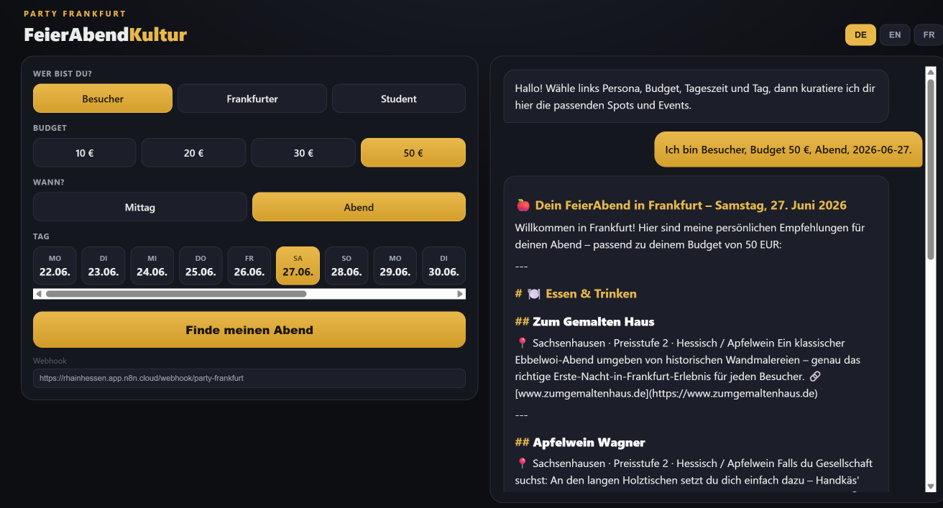
Am Nachmittag kam mein persönliches Highlight, der n8n Hackathon. Die Aufgabe: in drei Stunden, im Dreierteam, ein echtes Problem für ein Frankfurter Business lösen und alles live in n8n bauen. Unser Team, die „Rhinos“, hat dabei „FeierAbendKultur Frankfurt“ auf die Beine gestellt, einen Ausgeh- und Kulturconcierge.

Die Idee ist einfach: Man wählt seine Persona, also Besucher, Frankfurter oder Student, dazu Budget, Tageszeit und Wochentag. Dann bekommt man in Sekunden einen kuratierten Abend aus Essen und Events, mit echten lokalen Tipps, auf Deutsch, Englisch oder Französisch. Wichtig war uns, dass alles live läuft und kein Mockup ist. Im Hintergrund arbeiten ein WebScraper, der die Frankfurter Eventszene täglich selbst einliest, eine Airtable-Datenbank mit Dublettencheck, ein Plakat-Scanner über Mistral OCR und ein kleiner Chatbot, der daraus den passenden Plan formuliert.

FeierAbendKultur Frankfurt, der Ausgeh- und Kulturconcierge des Teams Rhinos  (nachgebaute Vorschau)

Gefühlt hatte die Hälfte der Teams Ideen rund um Frankfurt, Events und Ausgehen, entsprechend dicht war die Konkurrenz. Verdient gewonnen haben am Ende die Teams mit dem klarsten Nutzen und einer guten Portion Humor, etwa „Bears“ mit einem Meldesystem für kaputte Stellen in der Stadt und „Bulls“ mit ihrer „Frankfurt Pigeon Intelligence Agency“. Auf dem Papier lagen wir nicht vorne, aber das war an dem Tag fast egal. Was bleibt, ist der Beweis, wie schnell man mit No-Code und KI von der Idee zu etwas Lauffähigem kommt.

Tag 4: Keynotes und Systemdesign

Der Vormittag gehörte Sebastian Mertens von Make und der Keynote von Artur Mkrtchyan von Softr. Sein Punkt ist mir hängen geblieben: Kein Unternehmen will am Ende 8.000 Zeilen KI-generierten Spaghetti-Code besitzen oder Apps bauen, die unkontrolliert sensible Daten preisgeben. Was Unternehmen brauchen, ist visuelle Logik, klare Berechtigungen und Software, die sie selbst verstehen. KI ersetzt No-Code nicht, sie macht es schneller.

Danach wurde es technisch. Eine Session ist tief in das Zusammenspiel von n8n und Claude Code eingestiegen. Parallel lief ein Open Mic von Askan Schmeisser über Mattermost, den selbst hostbaren Open-Source-Zwilling zu Slack und Teams. Auf einem günstigen Hetzner-Server wird daraus eine gute Spielwiese für KI-Agenten wie Hermes oder OpenClaw, die sich als Bot in die Channels einklinken und in Threads mitlesen.

Mein eigenes n8n-Setup für die Orchestrierung ist über die Zeit ziemlich groß geworden, zu groß, um es in einer Stunde zu erklären. Deshalb habe ich mich am Abend hingesetzt und ein neues, schlankes Setup aufgebaut, das nur auf den nativen n8n-Skills und dem originalen n8n-MCP (Model Context Protocol) basiert. Das war meine Vorbereitung für den letzten Tag.

Tag 5: Open Mic und Abschluss

Der Finaltag startete mit einer schönen Überraschung, einem spontanen Ständchen für das Orga-Team. Auch wenn nur noch rund 40 Leute da waren, weil viele schon abgereist waren, war das ein richtig guter Moment.

Im Open Mic habe ich dann meinen umgebauten n8n Coworker vorgestellt, unter dem Titel „Automate your Automation“. Ich habe gezeigt, wie man mit dem Standard n8n-MCP und den n8n-Skills im Claude Setup arbeitet, als einfachen Einstieg ins Orchestrieren und Bauen von Workflows. Aus geplanten 45 Minuten wurden schnell zwei Stunden, und die Diskussionen danach waren das Wertvollste am ganzen Tag. Den Nachmittag haben wir genutzt, um das Gelernte zu sortieren, der Abend ist bei gutem Essen und kühlem Weißwein ausgeklungen. Der Termin für die nächste No Code Week steht übrigens schon: der 17. Mai 2027.

Abstecher: Keynote an der Hochschule Mainz

Direkt im Anschluss ging es für mich noch an die Hochschule Mainz, zur suMIT 2026, ausgerichtet vom IT Klub Mainz und Rheinhessen e.V. Dort durfte ich vor Studierenden meine Keynote „From Automation to Autonomy“ halten.

Ich habe zwei Use Cases aus der Praxis gegenübergestellt, einmal so, wie ich früher gearbeitet habe, und einmal so, wie moderne Systeme heute laufen. Mir ging es vor allem um einen Gedanken: Erst die Kombination aus einem deterministischen Rückgrat und probabilistischer KI macht ein System wirklich autonom. Die vielen Fragen der Studierenden im Anschluss waren ein schöner Abschluss, und ein gutes Zeichen, wie groß das Interesse an echter Praxis abseits der Theorie ist.

Der Tech Stack der Woche

Wer es konkret mag, hier die Werkzeuge, mit denen ich gearbeitet habe:

  • Workflow-Steuerung und Modelle: n8n, self hosted auf Hetzner für maximale Datenhoheit. Open-Source- oder Vollmodelle auf Ionos. Supabase als Open-Source-Lösung zum selbst Hosten. T.5 (Tensorfive) als Datenbank aus Mainz. Mistral als europäisches Modell.
  • Schnittstellen und Protokolle: MCP, n8n Standard Skills, Make Standard Skills.
  • Infrastruktur und Frontend: Airtable, Softr, WebApps mit Claude Code.

Unsere Kompetenzfelder

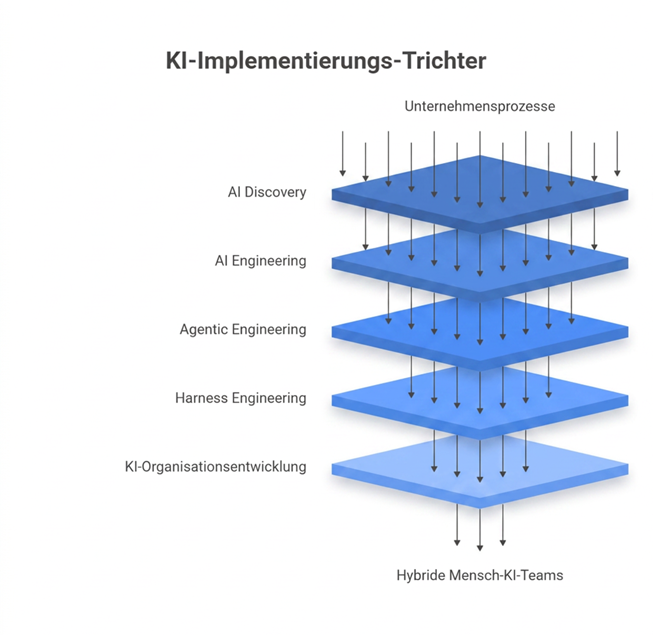
So ordnen wir bei VARY.FY unsere Arbeit ein, von der Organisation bis zur Pipeline:

  • KI-Organisationsentwicklung × Hybride Mensch-KI-Teams
  • Harness Engineering × Responsible AI
  • Agentic Engineering × AI Orchestration
  • AI Engineering × Data, Pipelines & RAG
  • AI Discovery × Process & Organisational Mining

VARY.FY Kompetenzfelder im Überblick

Diese fünf Felder greifen ineinander und ergeben einen durchgängigen Weg. Wir starten mit der Discovery und der Frage, wo sich KI im Unternehmen wirklich lohnt. In Plan und Design entwerfen wir darauf die passende Lösung. Danach folgt die Implementierung, also der Aufbau mit Daten, Pipelines und Orchestrierung. Im Enablement befähigen wir die Teams, sicher damit zu arbeiten. Und in der Organisationsentwicklung verankern wir KI dauerhaft in Strukturen, Rollen und Verantwortlichkeiten, sodass Mensch und KI verlässlich zusammenarbeiten.

Was ich mitnehme

Autonomie kommt nicht aus einem einzelnen Tool. Sie entsteht, wenn die Bausteine sauber zusammenspielen. Wer seine Workflows selbst hostet, behält die Kontrolle über die Daten. Wer auf offene Protokolle wie MCP setzt, bleibt unabhängig. Und wer KI orchestriert, statt nur einzelne Aufgaben zu automatisieren, kommt der Autonomie ein gutes Stück näher.

Das ist auch der Punkt, an dem wir mit VARY.FY ansetzen, an der Schnittstelle von Technologie, Recht und Ethik. Souveräne KI ist für mich die Voraussetzung dafür, dass Unternehmen KI rechtssicher und im Sinne des AI Act einsetzen können. Genau dabei unterstützen wir als Interim-AI-Manager.

Wenn Sie diesen Weg gehen wollen, ohne die Kontrolle abzugeben, sprechen Sie mich gerne an.

Autor

Sascha Scheffler ist diplomierter Maschinenbauingenieur und Experte für digitale Transformation. Er ist zertifizierter Lean Administration Expert, hat einen Master in Business with AI (MBAI®) und ist AI Integration Expert.

Vereinbaren Sie jetzt Ihren Beratungstermin! https://varyfy.de/kontakt/
Tokens verstehen: So nutzen Sie den VARY.FY Token-Rechner

Tokens verstehen

So nutzen Sie den VARY.FY Token-Rechner

Künstliche Intelligenz rechnet nicht mit Wörtern, sondern mit Tokens. Wie viele Tokens ein Text erzeugt, entscheidet darüber, wie schnell ein Modell arbeitet und was eine Anfrage kostet. Mit unserem Token-Rechner sehen Sie beides auf einen Blick.

Der VARY.FY Token-Rechner ist unter https://varyfy.de/tokenrechner/ aufrufbar und steht zur freien Verfügung.

In drei Schritten zeigen wir Ihnen, wie das Werkzeug funktioniert.

Schritt 1: Text eingeben

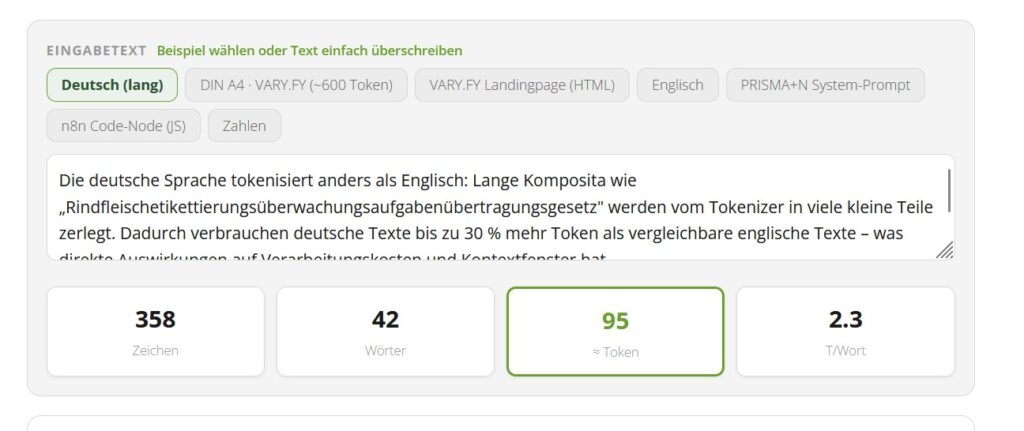
Oben finden Sie das Eingabefeld. Tippen Sie Ihren eigenen Text hinein oder überschreiben Sie den Beispieltext. Wenn Sie schnell starten möchten, wählen Sie einen der Beispiel-Buttons, etwa eine DIN A4 Seite oder einen System-Prompt. Über den Schalter oben rechts wechseln Sie zwischen Deutsch und Englisch.

Direkt unter dem Feld sehen Sie sofort die wichtigsten Kennzahlen: Zeichen, Wörter und die geschätzte Anzahl an Tokens.

Schritt 2: Die passende Sektion öffnen

Alle Bereiche lassen sich einzeln auf und zuklappen, damit Sie sich auf das konzentrieren, was Sie gerade brauchen.

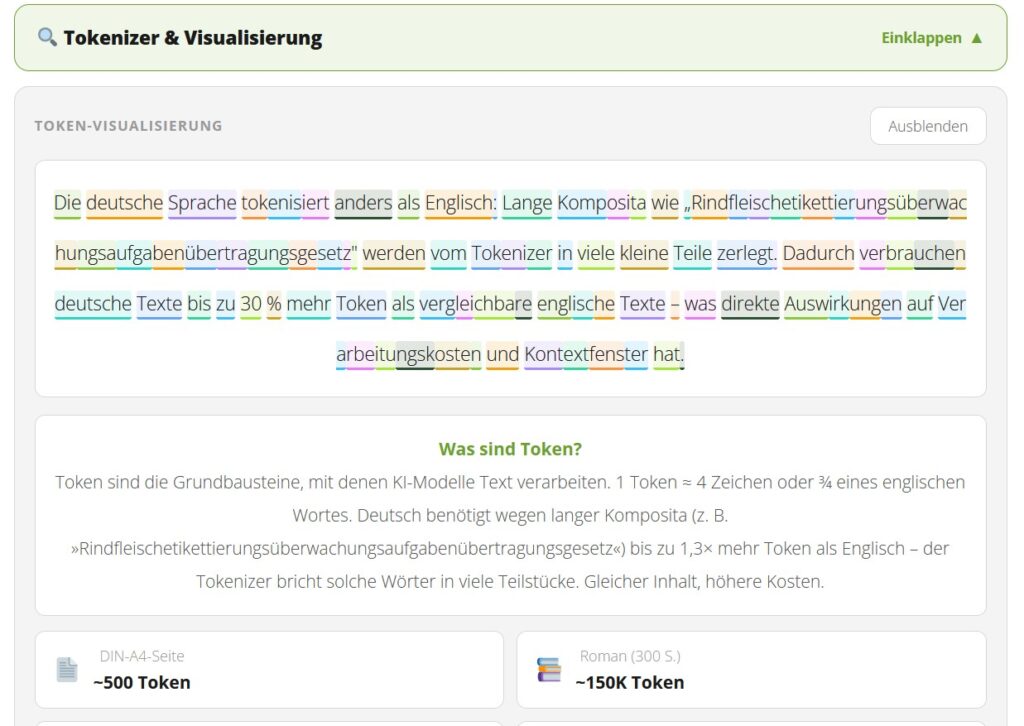
  • Tokenizer und Visualisierung: Hier wird Ihr Text farbig in einzelne Tokens zerlegt. So sehen Sie, dass lange deutsche Wörter in mehrere Teile zerfallen und dadurch mehr Tokens verbrauchen als kurze englische.
  • Vom Wort zur Zahl: Diese Sektion erklärt Schritt für Schritt, wie aus Text Mathematik wird, von der Tokenisierung über die Token-ID bis zum Zahlen-Vektor. Eine interaktive Tabelle übersetzt Ihren Text live in Zahlen.
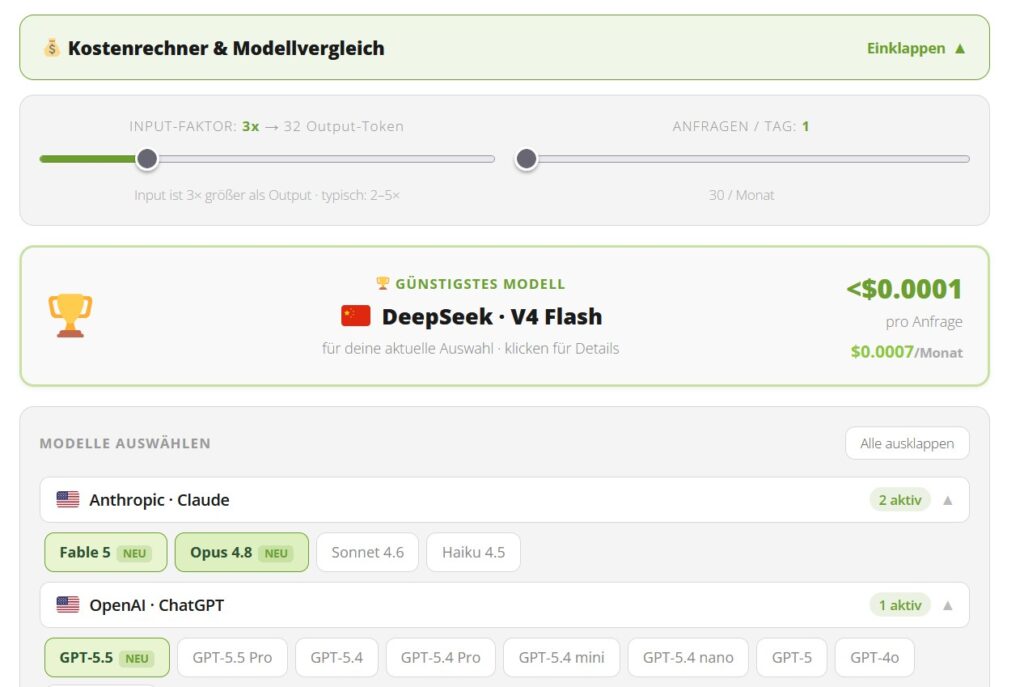
  • Kostenrechner und Modellvergleich: Wählen Sie ein oder mehrere Modelle aus und vergleichen Sie die Kosten. Sie stellen ein, wie viele Anfragen pro Tag anfallen und wie sich Eingabe und Ausgabe verteilen.
  • Kosten über die Zeit: Ein Diagramm zeigt, wie sich die Kosten über zwölf Monate summieren. Bewegen Sie den Regler von einer Anfrage pro Tag nach oben und beobachten Sie, wie die Kurve steigt.

Schritt 3: Modelle und Preise vergleichen

Im Kostenrechner sind die aktuellen Modelle hinterlegt, von Anthropic über OpenAI und Google bis zu Moonshot und Mistral. Eine kleine Flagge zeigt das Herkunftsland. Das günstigste Modell für Ihre Auswahl wird automatisch hervorgehoben, sodass Sie auf einen Blick die wirtschaftlichste Option erkennen.

Gut zu wissen

Die Token-Zahl ist eine fundierte Schätzung und kein offizieller Wert eines bestimmten Anbieters. Für die Budgetplanung ist sie sehr gut geeignet. Für die centgenaue Abrechnung sollten Sie die offiziellen Werte des jeweiligen Anbieters heranziehen.

Fazit

Mit dem Token-Rechner verstehen Sie in wenigen Minuten, wie ein Sprachmodell Ihren Text verarbeitet und was der Einsatz kostet. Ein Sprachmodell ist im Kern ein mathematisches Modell, und genau dieses Verständnis ist die Grundlage für einen sicheren und wirtschaftlichen Einsatz. Wenn Sie KI rechtssicher nutzen möchten, begleitet VARY.FY Sie an der Schnittstelle von Technologie, Recht und Ethik.

Autor

Sascha Scheffler ist diplomierter Maschinenbauingenieur und Experte für digitale Transformation. Er ist zertifizierter Lean Administration Expert, hat einen Master in Business with AI (MBAI®) und ist AI Integration Expert.

Vereinbaren Sie jetzt Ihren Beratungstermin! https://varyfy.de/kontakt/
Rule of Two: DSGVO-Leitplanken für KI-Agenten

Rule of Two: DSGVO-Leitplanken für KI-Agenten

Die spanische Datenschutzbehörde (AEPD) hat im Februar 2026 einen 71-seitigen Leitfaden zur Nutzung von KI-Agenten veröffentlicht. Darin beschreibt sie eine simple, aber äußerst wirksame Regel für den sicheren Einsatz von KI-Agenten:

die „Rule of Two“.

Was ist die Rule of Two?

Die Grundregel ist denkbar einfach

Ein KI-Agent sollte maximal 2 von 3 dieser Eigenschaften gleichzeitig haben:  

  1. Verarbeitung nicht-vertrauenswürdiger Eingaben
    z.B. User-Prompts, E-Mails von außen, Formulardaten aus dem Web
  2. Zugriff auf sensible Daten
    z.B. Kundendatenbank, Gesundheitsdaten, Finanzdaten, Personaldaten
  3. Autonome Aktionen mit Personenbezug
    z.B. automatisch E-Mails versenden, Zahlungen auslösen, Daten löschen, Verträge abschließen

Die Kombination aller drei ohne menschliche Aufsicht ist zu vernmeiden:

Vereint ein KI-Agent alle drei Eigenschaften, werden weitere Maßnahmen las Minimum erforderlich:

  • Zusätzliche Sicherheitsmaßnahmen
    Verstärkte Authentifizierung, Prompt-Injection-Schutz, Input-Validierung, Anomalie-Erkennung
  • Verpflichtende menschliche Aufsicht (Human-in-the-Loop)
    Kritische Aktionen müssen vor der Ausführung von Menschen geprüft und freigegeben werden
  • Erweiterte Dokumentation für DSGVO-Compliance
    Detaillierte Risikoanalyse, Datenschutz-Folgenabschätzung (DSFA), Aufzeichnung aller Entscheidungen

Die Rule of Two wird zwar für sich gesehen nicht allein ausreichen, um für eine DSGVO-konformität bei dem Einsatz von KI-Agenten zu sorgen, sie ist aber mindestens mehr als nur eine technische Empfehlung.

Unternehmen, die diese Regel bei der Entwicklung und dem Betrieb von KI-Agenten berücksichtigen, reduzieren nicht nur rechtliche Risiken, sondern schaffen auch vertrauenswürdigere Systeme für ihre Nutzer. Die „Rule of Two“ gehört zumindest für die Entwicklung von KI-Agenten, auch in zur KI-Kompetenz.

Quelle und weiterführende Informationen

Die vollständigen Leitlinien der AEPD finden Sie hier:
Agentic Artificial Intelligence – AEPD Guide (PDF)

Autor

Matthias Rosa ist Rechtsanwalt und Fachanwalt für IT-Recht und schwerpunktmäßig im Datenschutz-, KI- und Datenrecht tätig.

Vereinbaren Sie jetzt Ihren Beratungstermin! https://varyfy.de/kontakt/
KI-Kennzeichnungspflicht im Unternehmen

Transparenzpflichten für KI

Maschinen kommunizieren heute so menschenähnlich, dass viele Menschen nicht mehr erkennen können, ob sie mit einer Person oder einer KI sprechen. So gehören Chatbots, KI-Telefonassistenten, automatisch erstellte Texte – KI-Tools mittlerweile zu unserem Alltag.  Mit der Verordnung (EU) 2023/2854, dem AI Act, gellten nunmehr bestimmte Kennzeichnungspflichten für den Einsatz von KI in der gesamten EU. Wer künstliche Intelligenz einsetzt, muss transparent machen, wann Nutzer mit einer Maschine sprechen oder KI-Inhalte konsumieren.

Mit dem folgenden Beitrag soll ein Überblick über die wichtigsten Regelungen in diesem Zusammenhang dargestellt werden.

Warum sieht der AI Act überhaupt Transparenzpflichten vor?

Zur Beantwortung dieser Frage schauen wir uns zunächst ein aktuelles prominentes Beispiel an.

Betrüger erstellten gefälschte Videos, in denen ein KI-generierter Eckart von Hirschhausen für dubiose Gesundheitsprodukte warb. Viele Menschen fielen darauf herein. Der Arzt und Moderator sah sich selbst veranlasst, öffentlich vor dieser Geschäftspraxis zu warnen und ging in einer Sendung dem Ganzen selbst auf den Grund.[1]

Das Beispiel veranschaulicht, warum Transparenzpflichten sinnvoll sind. Durch die Kennzeichnung von KI-generierten oder manipulierten Inhalten sollen Nutzerinnen und Nutzer in die Lage versetzt werden, informierte Entscheidungen zu treffen. Sie sollen nicht Opfer gezielter Betrugsmaschen oder Desinformationskampagnen, z.B. bei Wahlen[2], werden.

Welche Transparenzpflichten gibt es überhaupt?

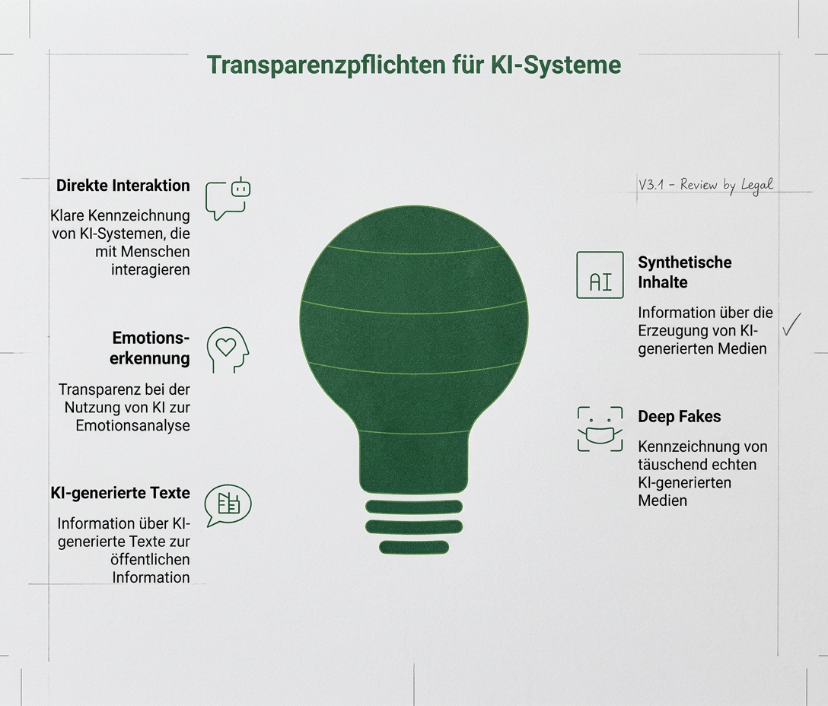
Der AI Act unterscheidet 5 zentrale Transparenzpflichten:

  • Direkte Interaktion zwischen KI mit Menschen: Die erste Transparenzpflicht betrifft digitale Telefonassistenten, Chatbots oder interaktive Software-Systeme. Erfasst wird grundsätzlich jedes KI-System, unabhängig von seiner Risikoklasse. Entscheidend ist allein die direkte Interaktion mit natürlichen Personen.
  • Erzeugung synthetischer Inhalte: Die zweite Kategorie umfasst KI-Systeme, die synthetische Audio-, Bild-, Video- oder Text-Inhalte erzeugen. Dies betrifft auch generative KI-Systeme (Gen-AI) mit allgemeinem Verwendungszweck, wie sie heute in vielen Unternehmen zum Einsatz kommen.
  • Emotionserkennungssysteme und biometrische Kategorisierung: Die dritte Pflicht bezieht sich auf besonders sensible KI-Anwendungen. Solche Systeme dienen dem Zweck, Emotionen oder Absichten natürlicher Personen auf der Grundlage ihrer biometrischen Daten festzustellen oder daraus abzuleiten. Wenn Unternehmen solche Systeme einsetzen, müssen sie Nutzer klar und deutlich darüber informieren. Hinzu kommen an dieser Stelle auch die Informationspflichten gemäß der Datenschutzgrundverordnung (DSGVO), die zusätzlich zu beachten sind.
  • Deep Fakes: Die vierte Kategorie betrifft sogenannte Deep Fakes. Hierbei handelt es sich um täuschend echt wirkende Medieninhalte, bei denen mithilfe künstlicher Intelligenz Gesichter, Stimmen oder Handlungen von Personen so verändert oder nachgebildet werden, dass diese Personen scheinbar Dinge sagen oder tun, die sie in Wirklichkeit nie gesagt oder getan haben. Der generierte Inhalt muss fälschlicherweise als echt oder wahr erscheinen und für die Öffentlichkeit bestimmt sein.
  • KI-generierte Texte zur Information der Öffentlichkeit: Die fünfte und letzte Transparenzpflicht bezieht sich auf KI-generierte Texte, die der öffentlichen Information dienen. Betroffen sind Texte zu politischen Ereignissen, Wahlen, Gesundheitskrisen, Umweltthemen oder wirtschaftlichen Entwicklungen

Wer ist verpflichtet?

Das Gesetz verpflichtet Anbieter und Betreiber von KI-Systemen. Die Transparenzpflichten für KI sind unterschiedlich verteilt.

Anbieter von KI-Systemen

Der Anbieter ist dabei derjenige, der das KI-System entwickelt oder entwickeln lässt und es unter seinem Namen oder seiner Marke auf den Markt bringt oder in Betrieb nimmt (z.B. Open AI, Google, Anthropic). Anbieter tragen die Verantwortung dafür, dass ihre KI-Systeme technisch so konzipiert und entwickelt werden, dass die Nutzer darüber informiert werden, dass sie es mit einem KI-System zu tun haben. Dies könnte beispielsweise durch eine entsprechende Kennzeichnung oder einen automatischen Hinweis auf der Nutzeroberfläche erfolgen.

Betreiber von KI-Systemen

Betreiber ist derjenige, der ein bereits existierendes KI-System tatsächlich nutzt – und zwar unter eigener Verantwortung (nicht nur privat, sondern beruflich/gewerblich). Beispiele sind etwa ein Unternehmen, das ChatGPT für Kundenservice nutzt, eine Marketingagentur, die mit Midjourney Werbebilder erstellt oder ein Verlag, der KI-Tools zur Texterstellung einsetzt.

Was müssen Anbieter und Betreiber tun?

Anbieterpflichten

Transparenzpflichten für KI, die die direkte Interaktion mit Menschen betrifft, treffen zunächst die Anbieter solcher KI-Systeme. Sie müssen dafür sorgen, dass diese so konzipiert und entwickelt werden, dass die Nutzer darüber informiert werden, dass sie es mit einem KI-System zu tun haben. Dies könnte beispielsweise durch eine entsprechende Kennzeichnung oder einen Hinweis auf der Nutzeroberfläche erfolgen.

Ausnahmen sind dann denkbar, wenn es jedem Nutzer offensichtlich ist, dass dieser es mit einem KI-System zu tun hat.

Anbieter sind auch bei der Erzeugung sogenannter synthetischer Inhalte in der Pflicht. So müssen alle Ausgaben in einem maschinenlesbaren Format gekennzeichnet sein, zum Beispiel in den Metadaten, damit erkannt werden kann, dass sie künstlich erzeugt oder manipuliert wurden. Ausnahmen bestehen dann, wenn das System lediglich eine Hilfsfunktion für die Standardredaktion erfüllt oder bei der Strafverfolgung eingesetzt wird.

Betreiberpflichten

Betreiber wiederum müssen sicherstellen, dass Nutzer klar und deutlich darüber informiert sind, wenn ein Emotionserkennungssystem sowie eine biometrische Kategorisierung zum Einsatz kommen. Es handelt sich um eine umfassende Transparenzpflicht. Hinzu kommen an dieser Stelle aber auch die Informationspflichten gemäß Datenschutzgrundverordnung (DSGVO).

Ebenso treffen Betreiber entsprechende Kennzeichnungspflichten für Deep Fakes, etwa durch Texteinblendungen wie „KI-generiert“ oder „Dieser Inhalt wurde künstlich erstellt“. Ausnahmen gibt es auch hier bei der Strafverfolgung oder etwa bei Künstlerischen, kreativen, satirischen oder fiktionalen Inhalte, sofern die Garantien den Interessen und Grundrechten Dritter angemessen Rechnung tragen. Hier steht die Kunstfreiheit im Vordergrund.

Die Transparenzpflicht für Betreiber trifft auch bei Texten zu politischen Ereignissen, Wahlen, Gesundheitskrisen, Umweltthemen oder wirtschaftlichen Entwicklungen zu. Auch hier kann mit Hinweisen, wie z.B. „Dieser Artikel wurde mithilfe von KI erstellt“ oder „KI-generierter Inhalt“ gearbeitet werden.“

Allerdings besteht hier, ebenfalls wieder neben der Strafverfolgung dann eine Transparenzausnahme, wenn eine Nachrichtenredaktion KI zur Unterstützung bei der Erstellung von Artikelentwürfen einsetzt. Die Artikel müssen jedoch dabb von Journalisten überprüft, bearbeitet und freigegeben sein, bevor sie veröffentlicht werden.  

Allgemeine Pflichten

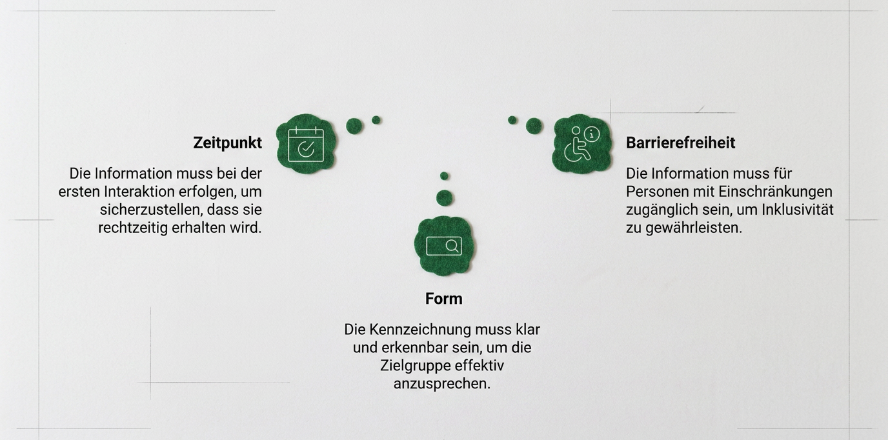
Egal, ob man als Betreiber oder Anbieter eines KI-Systems von den Transparenzpflichten betroffen ist, gelten immer diese Anforderungen:

Ab wann sind die Transparenzpflichten für KI verbindlich umzusetzen?

Auch wenn der AI Act bereits am 01. August 2024 in Kraft getreten ist, gelten die Transparenzpflichten ab dem 02.August 2026.

Was droht bei Verstößen?

Verstöße gegen die Transparenzpflichten können empfindliche Sanktionen nach sich ziehen. Bußgelder von bis zu 15 Millionen Euro oder drei Prozent des weltweiten Jahresumsatzes – je nachdem, welcher Betrag höher ist – sind möglich. Unternehmen sollten daher ihre KI-Nutzung umgehend prüfen und geeignete Kennzeichnungslösungen implementieren.

Transparenz als Wettbewerbsvorteil nutzen

Der AI Act markiert einen Wendepunkt im Umgang mit Künstlicher Intelligenz in Europa. Transparenz ist dabei nicht nur eine rechtliche Pflicht, sondern kann auch ein echter Wettbewerbsvorteil sein. Unternehmen, die frühzeitig auf klare Kennzeichnung setzen, schaffen Vertrauen bei Kunden und Geschäftspartnern. In einer Zeit, in der Desinformation und Manipulation durch KI zunehmen, wird Transparenz zu einem wertvollen Gut. Kunden schätzen es, wenn Unternehmen offen mit dem Einsatz von KI umgehen und ehrlich kommunizieren, wo Maschinen zum Einsatz kommen und wo Menschen arbeiten.

Zudem vermeiden Sie durch proaktive Compliance teure Bußgelder und langwierige Auseinandersetzungen mit Aufsichtsbehörden. Die Investition in eine rechtssichere Kennzeichnung zahlt sich also mehrfach aus – rechtlich, wirtschaftlich und im Hinblick auf Ihre Reputation.

Wie Sie jetzt vorgehen sollten?

Sie sind unsicher, ob Ihre KI-Anwendungen den neuen Anforderungen entsprechen? Kontaktieren Sie uns für eine kostenlose Ersteinschätzung. Wir prüfen Ihre Systeme, entwickeln eine maßgeschneiderte Compliance-Strategie und unterstützen Sie bei der rechtssicheren Implementierung.

Autorin

Sarah Tavcer ist Rechtsanwältin und seit einigen Jahren als externe Datenschutzbeauftragte und Datenschutzberaterin tätig. Außerdem ist die zertifizierte KI-Compliance-Beauftragte.

Vereinbaren Sie jetzt Ihren Beratungstermin! https://varyfy.de/kontakt/
LINK zu unserer Checkliste: Download


[1] https://presse.wdr.de/plounge/wdr/programm/2026/04/20260401_hirschhausen_deepfake_mafia.html

[2] https://www.deutschlandfunk.de/ki-wahlen-manipulation-kuenstliche-intelligenz-fake-news-deepfakes-100.html